Core
Datenbereinigung: Warum KI keine Wunderlösung ist
Nathalie · 2026-07-03 · 3 Min. Lesezeit
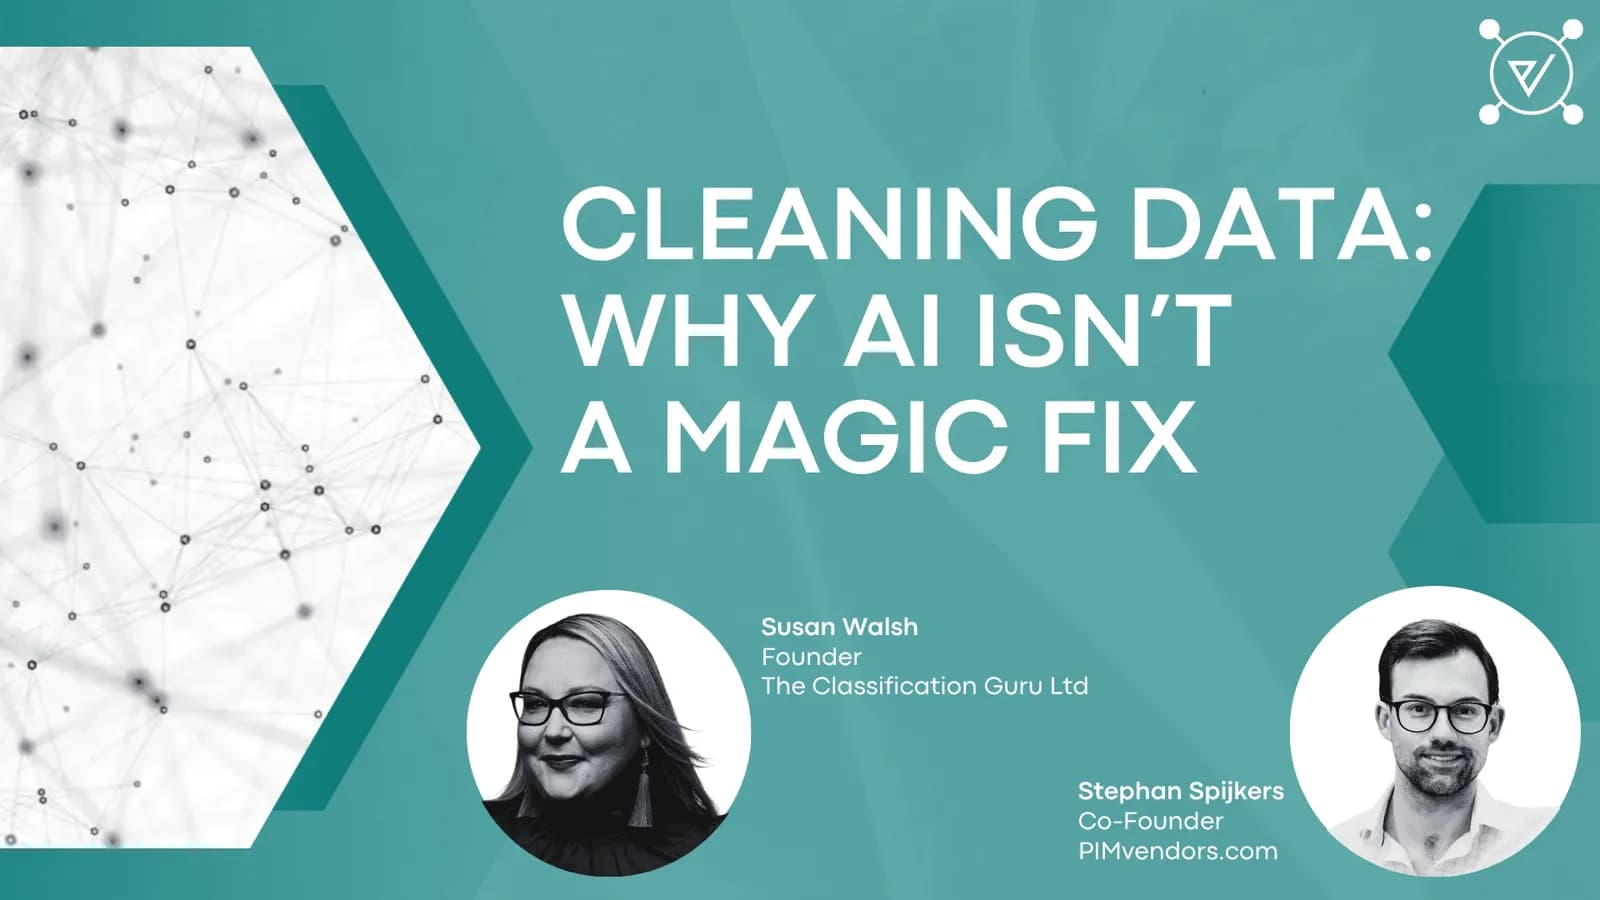
Die meisten Unternehmen haben in diesem Jahr KI gekauft, um ihre Datenprobleme zu lösen. Bekommen haben sie stattdessen einen schnelleren und umfassenderen Blick darauf, wie groß diese Probleme schon waren. In diesem Webinar von PIMvendors.com spricht Mitgründer Stephan Spijkers mit Susan Walsh, in der Datenwelt bekannt als „The Classification Guru“. Gemeinsam ordnen sie ein, wo KI bei der Arbeit mit Produkt- und Geschäftsdaten wirklich ihren Wert beweist, wo sie ein Durcheinander still und leise vergrößert und warum die Lösung weiterhin über Menschen führt und nicht über Prompts.
Sprecher Stephan Spijkers - Mitgründer, PIMvendors.com
Susan Walsh - Gründerin, The Classification Guru Ltd. Neun Jahre praktische Erfahrung in der Klassifizierung und Bereinigung von Daten für mehr als 100 Kunden weltweit, Autorin von zwei Büchern über die Sanierung schmutziger Daten.
KI verstärkt das Chaos, das Sie schon haben Susans Auftragslage ist gewachsen, seit KI breiter eingesetzt wird, und sie führt das direkt auf die Technologie zurück: KI unterscheidet nicht zwischen sauberen und schmutzigen Daten, sie verarbeitet nur schneller und verbreitet das Ergebnis weiter. Ein Unternehmen mit uneinheitlichen Produktbezeichnungen oder nicht passenden Maßeinheiten bekommt das durch KI nicht repariert. Die Inkonsistenz wird vielmehr in jedem nachgelagerten System vervielfacht, das mit diesen Daten arbeitet.
Kein einzelnes Modell gewinnt jede Aufgabe Susan widerspricht der Idee, ein einziges KI-Tool auszuwählen und für alles zu nutzen. GPT, Claude und die Modelle von Google eignen sich jeweils für unterschiedliche Aufgaben, und die richtige Wahl hängt von den Daten und der konkreten Aufgabe ab. Sie nutzt KI, um Ideen zu schärfen und Berichte zu entwerfen, lässt sie aber nicht unbeaufsichtigt als Agent laufen. Als Beispiel nennt sie die Entscheidung von Ford, rund tausend Mitarbeitende wieder einzustellen, nachdem die KI-gestützte Automatisierung hinter den Erwartungen zurückblieb.
Mustererkennung ist kein Kontext Das anschaulichste Beispiel aus dem Gespräch: Susans Team baute ein KI-Modul, um Lieferantennamen zu vereinheitlichen, und es fasste drei völlig unabhängige Firmen (einen Friseursalon, eine Reinigungsfirma und eine Anwaltskanzlei, die zufällig alle Walsh hießen) zu einer einzigen Gruppe zusammen. Das Modell sah ein wiederkehrendes Wort und nahm eine Übereinstimmung an. Bei großen Mengen, etwa in einer Tabelle mit einer Million Zeilen, ist ein solcher Fehler mit bloßem Auge kaum zu finden.
Die Lösung ist Dokumentation, keine einmalige Bereinigung Auf die Frage, wofür sie ein begrenztes KI-Budget einsetzen würde, entschied sich Susan für Dokumentation statt für einen einmaligen Bereinigungsdurchlauf. Technologien wechseln alle paar Jahre, doch klare Regeln dafür, wie Daten erfasst, formatiert und benannt werden, bleiben gültig, ganz gleich, welches Tool ein Unternehmen nutzt. Saubere Daten ohne Dokumentation werden innerhalb weniger Monate wieder schmutzig.
Wo KI ihren Platz wirklich verdient Beide Sprecher sind sich einig, dass KI bei überprüfbaren, klar definierten Aufgaben gut abschneidet: Tabellenformeln, Lookups, Mustererkennung in großen Datenbeständen. Schwächer ist sie bei subjektiven, kontextabhängigen Ermessensentscheidungen, also bei der Art von Klassifizierungsarbeit, die nach wie vor einen Menschen braucht, der das Geschäft hinter den Daten versteht.
Beginnen Sie mit einer Pivot-Tabelle, nicht mit einer Plattform Susans praktischer Ausgangspunkt für jedes Team, das mit dieser Arbeit anfängt: Produktdaten in eine Pivot-Tabelle ziehen, nach Beschreibung und Artikelnummer sortieren und nach Unstimmigkeiten suchen, die man in einem rohen Datensatz nie bemerken würde, die aber sofort ins Auge springen, sobald die Daten geordnet sind. Priorisieren Sie nach geschäftlicher Wirkung, nicht danach, was sich am leichtesten zuerst beheben lässt.
Susan Walsh bringt weitere Gedanken dazu am 6. Oktober in Utrecht auf die Product Content Europe, die Product-Content-Veranstaltung, die PIMvendors.com gemeinsam mit EMM Consultancy ausrichtet. Early-Bird-Tickets sind bis zum 15. Juli auf productcontenteurope.com erhältlich.
👉 Erfahren Sie, wie PIMvendors.com Teams dabei hilft, die Datengrundlage aufzubauen, die KI tatsächlich braucht: pimvendors.com
Diagnose
Brauchen Sie überhaupt ein PIM?
Ermitteln Sie Ihren Komplexitätsindex, bevor Sie Software budgetieren oder einen Systemintegrator beauftragen.
Budget
Erste TCO-Schätzung erstellen
Übersetzen Sie die Struktur Ihres Katalogs in weniger als zehn Minuten in eine Kostenspanne über drei Jahre.