Core
Single Source Folge 7: Produktdaten von Excel bis zum KI-PIM
Nathalie · 2026-05-13 · Aktualisiert am 2026-05-15 · 4 Min. Lesezeit
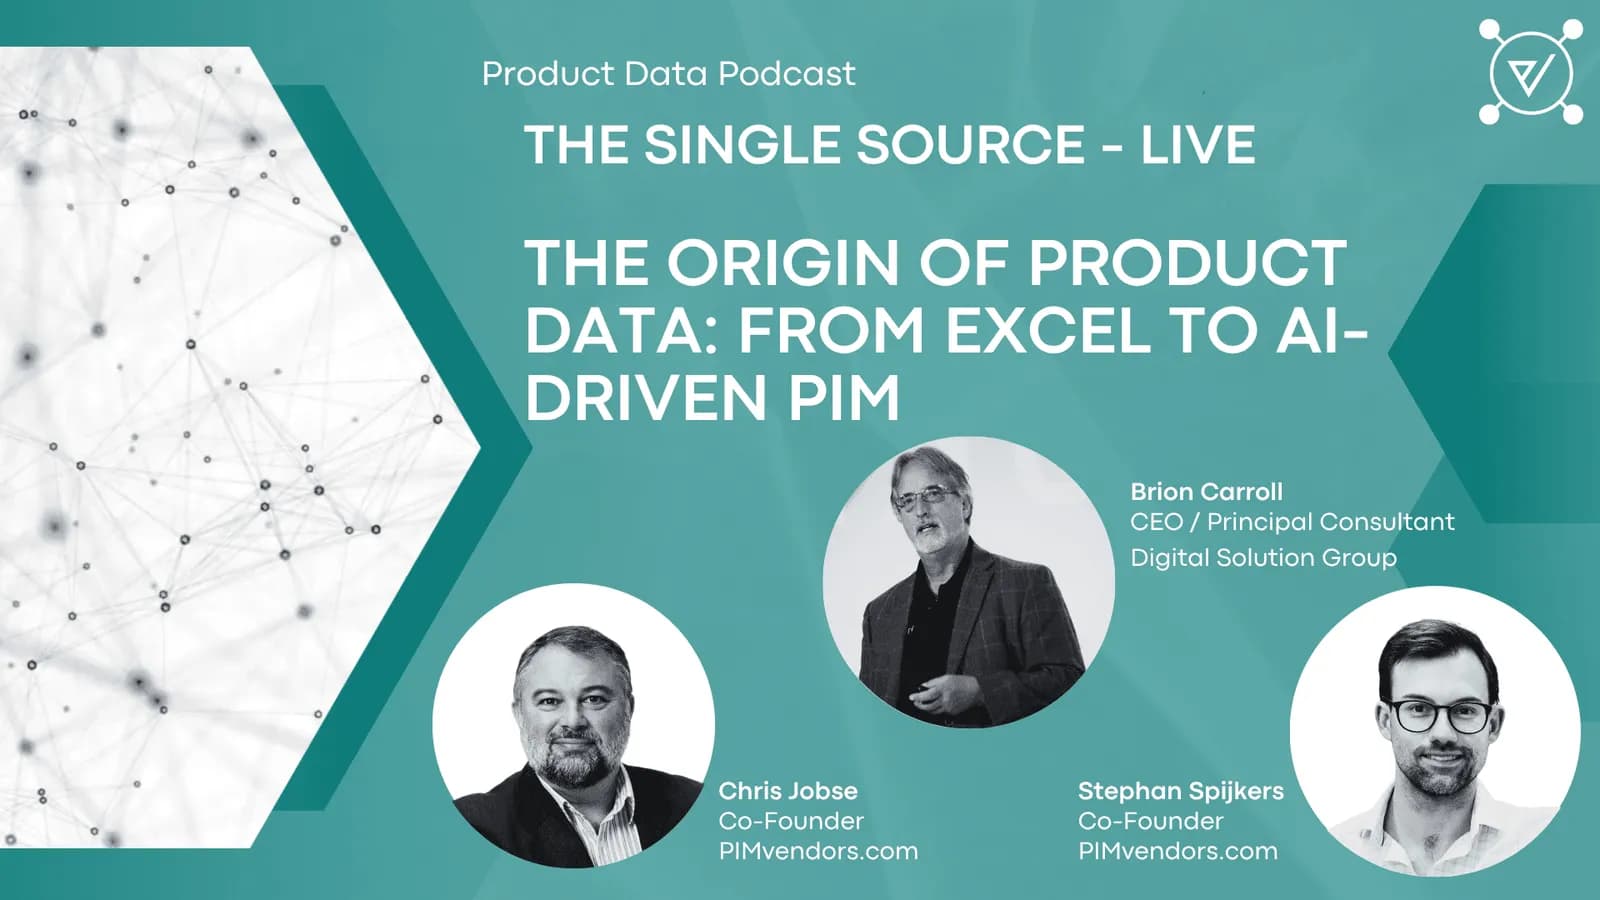
Die meisten Organisationen haben ihre Produktdaten nicht für KI entworfen. Sie haben sie geerbt: aus Tabellen, ERP-Systemen und einem Jahrzehnt angesammelter Behelfslösungen. In dieser Folge von The Single Source Podcast sprechen Stephan Spijkers und Chris Jobse von PIMvendors.com mit Brion Carroll darüber, wie Produktdaten den Weg von Excel zum KI-gestützten PIM genommen haben und was dieser Wandel von der zugrunde liegenden Architektur verlangt.
Das Gespräch behandelt die Grenze zwischen PIM, PLM und PDM, den Aufstieg des „Produktgedächtnisses“ als Grundlage für KI-Agenten und die Frage, was Data Governance tatsächlich erfordert, sobald KI vom Pilotprojekt in den Produktivbetrieb geht.
Sprecher:
Brion Carroll, CEO / Principal Consultant
Stephan Spijkers, Mitgründer, PIMvendors.com
Chris Jobse, Mitgründer, PIMvendors.com
Die ganze Folge ansehen
Die vollständige Session finden Sie auf dem YouTube-Kanal von PIMvendors. Wenn Ihre Organisation gerade neu darüber nachdenkt, wie Produktdaten KI-Agenten und den nachgelagerten Commerce speisen, behandelt diese Folge die strukturellen Fragen, die die meisten Anbieterpräsentationen auslassen.
Die wichtigsten Erkenntnisse:
PIM, PLM und PDM erfüllen unterschiedliche Aufgaben und lassen sich nicht in einem System zusammenfassen. Jedes steuert einen anderen Ausschnitt des Produktdaten-Lebenszyklus: PDM verantwortet Konstruktion und Designabsicht, PLM verwaltet Lebenszyklusphasen und Änderungssteuerung, und PIM macht Produktinhalte für Kanäle und Kunden vermarktbar. Organisationen, die diese Grenzen verwischen, erleben, wie ihre Architektur zerbricht, sobald KI-Workloads hinzukommen, denn KI-Agenten können widersprüchliche Definitionen dessen, was „das Produkt“ eigentlich ist, nicht auflösen.
Das Produktgedächtnis ist die Architekturschicht, die KI-Agenten verlässlich macht. Ein generischer Data Lake speichert Produktinformationen, ohne die Beziehungen, Hierarchien und Herkunftsangaben zu bewahren, die Agenten für vertrauenswürdige Antworten brauchen. Eine Schicht für das Produktgedächtnis bildet diese Beziehungen explizit ab und behandelt sie als vollwertige Infrastruktur. Implementierungen, die diese Schicht bewusst aufbauen, schneiden durchweg besser ab als solche, die KI auf undifferenzierte Produktdaten ansetzen.
Data Governance ist die Voraussetzung für jeden KI-Nutzen bei Produktdaten. Ohne klare Verantwortlichkeiten, vereinbarte Definitionen und kanalspezifische Qualitätskriterien beschleunigt KI die Inkonsistenz, statt sie zu verringern. Governance legt fest, was gute Daten im jeweiligen Kontext bedeuten, wer dafür verantwortlich ist und wie sie langfristig gepflegt werden. KI auf ungesteuerte Daten zu setzen, erzeugt undurchsichtige Ergebnisse auf Basis inkonsistenter Eingaben, und das im großen Maßstab.
Die Datenqualität begrenzt den Wert der KI-Ergebnisse. Ausgefeilte Modelle gleichen unvollständige Attribute, fehlende Beziehungen oder veraltete Datensätze nicht aus. Sie verstärken sie im großen Maßstab. In die Modellauswahl zu investieren, bevor in die Datenbereinigung investiert wird, ist die falsche Reihenfolge und einer der häufigsten Gründe, warum KI-Pilotprojekte nie in den Produktivbetrieb gelangen.
KI-Agenten schaffen nur dann Wert, wenn sie in einen gesteuerten Workflow eingebettet sind. Agenten, die mit ungesteuerten Produktdaten arbeiten, erzeugen mehr Nacharbeit, als sie verhindern. Die Folge betrachtet Agenten als Beteiligte im Workflow mit definierten Eingaben, Ausgaben und Prüfschritten, nicht als autonome Assistenten, die auf einen generischen Datensatz losgelassen werden. Diese Sichtweise verändert, wie Organisationen ihre ersten KI-Einsätze im PIM zuschneiden sollten.
Datenbeziehungen haben mehr KI-Wert als reine Attribute. Die meisten Produktdatenprogramme konzentrieren sich auf die Vollständigkeit der Attribute. Die Arbeit mit der größeren Hebelwirkung liegt in den Beziehungen zwischen Produkten, Komponenten, Kanälen und Compliance-Anforderungen. KI zieht aus gut strukturierten relationalen Daten überproportional viel Wert und aus flachen Attributlisten sehr wenig. Architekturen, die früh auf relationale Integrität setzen, skalieren deutlich besser, sobald KI-Agenten hinzukommen.
Eine KI-fähige Architektur ist von Grund auf iterativ. Schemata, Kanalanforderungen und die Fähigkeiten von Agenten ändern sich ständig. Wer die Datenarchitektur als festes Projektergebnis behandelt, garantiert, dass sie schon im ersten Produktzyklus veraltet. Laufende Iteration, Pflege und Budget gehören zur Architektur selbst und sind keine separaten Initiativen. Organisationen, die das vom ersten Tag an einplanen, vermeiden die teuren Replatforming-Zyklen, die starre Implementierungen später einholen.
👉 Sie fragen sich, ob Ihre Produktdatenarchitektur bereit ist für KI-Agenten und die nächste Generation von PIM?
Vergleichen Sie PIM-Lösungen und buchen Sie ein Gespräch mit unserem Team auf pimvendors.com
Diagnose
Brauchen Sie überhaupt ein PIM?
Ermitteln Sie Ihren Komplexitätsindex, bevor Sie Software budgetieren oder einen Systemintegrator beauftragen.
Budget
Erste TCO-Schätzung erstellen
Übersetzen Sie die Struktur Ihres Katalogs in weniger als zehn Minuten in eine Kostenspanne über drei Jahre.