Field
Ein Bergbaukonzern bündelte 500.000 Produktdatensätze
Nathalie · 2026-01-12 · Aktualisiert am 2026-10-23 · 6 Min. Lesezeit
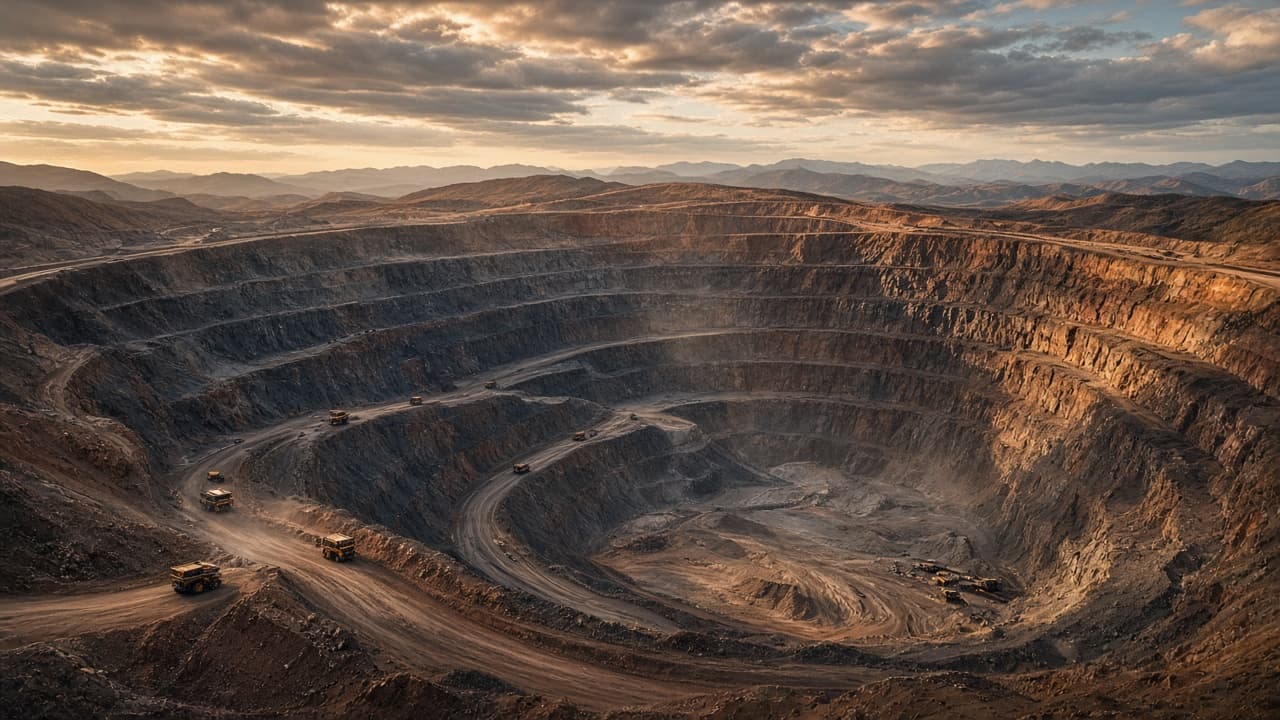
Der Bergbaukonzern hat einen Produktkatalog bekommen, indem er Datenmodell, Plattform und Anreicherung als einen Auftrag angegangen ist. Er arbeitet in 12 oder mehr Regionen. Jahrzehnte von Wachstum und Zukäufen hinterließen mehr als 500.000 Produktdatensätze über ERP-Instanzen, Beschaffungsplattformen und lokale Tabellen, in verschiedenen Sprachen und mit verschiedener Klassifikationslogik. PIMvendors hat ein UNSPSC-Modell entworfen, die PIM/MDM-Auswahl durchgeführt und industrielle KI auf die Bereinigung gesetzt, mit einer Person, die das Ergebnis prüft.
Die Ausgangslage
Dieselbe Hydraulikpumpe konnte als fünf Beschreibungen auftauchen, in drei Sprachen, unter zwei UNSPSC-Codes, ohne dass etwas sie verband. Für eine Gruppe, die pro Jahr Milliarden für MRO-Material ausgibt, ist diese Zersplitterung ein Kostenproblem, ein Sicherheitsproblem und ein Stillstandsproblem.
Instandhaltungsteams fanden die richtigen Teile nicht. Der Einkauf sah doppelte Ausgaben nicht. Strategischer Einkauf konnte Lieferanten nicht bündeln. Regionale Teams hatten gelernt, am Katalog vorbeizuarbeiten. Frühere Bereinigungen mit generischer KI und pauschaler Neuklassifikation waren gescheitert. Brecherauskleidungen, Förderbandsegmente und spezielle Filtermedien stehen nicht in Verbraucherdatenbanken. Generische Anreicherung lieferte deshalb Ergebnisse, die die Teams nicht nutzen konnten.
Die Gruppe hat PIMvendors mit drei Arbeitspaketen beauftragt: ein einheitliches Produktdatenmodell, eine PIM/MDM-Plattform und eine KI-Bereinigung und Anreicherung, gebaut für industrielles MRO.
Arbeitspaket 1: Produktdatenmodell
Keine zwei Regionen haben ein Produkt gleich beschrieben. Manche Standorte hielten technische Spezifikationen. Andere stützten sich auf Freitext, den Lagerkräfte getippt hatten. Es gab keine gemeinsame Taxonomie, keinen vereinbarten Attributsatz und keine Definition eines vollständigen Datensatzes.
PIMvendors hat das Modell auf UNSPSC gesetzt, die Klassifikation, die für indirektes Material und MRO am weitesten verbreitet ist. Regionale Strukturen wurden gegen dieses Modell gelegt, um Lücken, Konflikte und Dubletten zu finden. Jede Kategorie bekam Pflicht- und optionale Attribute, Standardeinheiten und Benennungsregeln, die in mehr als einer Sprache funktionieren.
Getestet wurde mit Einkaufsleitern, Instandhaltungsingenieuren und Lagerleitern in vier Pilotregionen. Der Test war operativ. Wenn ein Techniker eine Förderband-Tragrolle nicht innerhalb von drei Klicks aus der neuen Klassifikation und den Attributen fand, ging das Modell zurück zur Überarbeitung.
Das Ergebnis ist ein UNSPSC-Modell, das 100 % der MRO-Kategorien der Gruppe abdeckt. Jede Kategorie hat eine Attributvorlage und Prüfregeln, sodass die Qualität geprüft wird, wenn ein Datensatz entsteht.
Arbeitspaket 2: Plattformauswahl
Es gab kein zentrales führendes System. Die Stammdatenmodule der ERPs haben Transaktionen verarbeitet und boten keinen Arbeitsablauf, keine Governance und keine Anreicherung. Datenstewards führten ihre eigenen Golden Records in Excel. Eine zentrale Plattform musste Governance über mehrere Regionen, mehrere Sprachen und das Volumen eines industriellen MRO-Katalogs verkraften.
PIMvendors hat eine Longlist von mehr als 15 PIM- und MDM-Plattformen auf eine Shortlist von 3 gebracht. Die Kriterien waren konkret: UNSPSC-Hierarchien in dieser Größenordnung, die Aufnahme aus ERPs, die nicht zueinander passen, die Passung zu den KI-Werkzeugen des dritten Arbeitspakets und die IT-Architektur und Sicherheitsregeln der Gruppe.
Jeder Anbieter auf der Shortlist hat auf den Daten des Kunden demonstriert, nach einem Skript. Generische Demodaten kamen nicht zum Einsatz. In den Runden saßen IT, Einkauf, Instandhaltung und Data Governance. PIMvendors hat eine unabhängige Bewertung und eine Empfehlung geliefert, mit den Gesamtbetriebskosten über fünf Jahre.
Die Plattform war ausgewählt und die Roadmap für die Einführung lag innerhalb von 10 Wochen vor. Die Roadmap ist ausgelegt auf mehr als 500.000 SKUs, 12 oder mehr regionale Datenlieferungen und 8 Sprachen, mit Arbeitsabläufen für die Datenpflege, die Freigabe und die Aufnahme von Lieferanten.
Arbeitspaket 3: Bereinigung und Anreicherung
Auch nachdem Modell und Plattform gewählt waren, blieb die historische Datenlage ein Durcheinander. Über 40 % der Datensätze waren Freitext ohne strukturierte Attribute. Die Klassifikationsgenauigkeit über den Katalog lag geschätzt unter 60 %. Dubletten waren überall. Allgemeine Sprachmodelle, trainiert auf Verbraucherprodukten, konnten eine Absperrklappe vom Typ 3 nicht von einer vom Typ 5 unterscheiden und eine Kugelmühlenauskleidung nicht von allgemeiner Metallware.
PIMvendors hat KI-Werkzeuge identifiziert, bewertet und eingesetzt, die für industrielle Anreicherung und MRO gebaut sind. Diese Werkzeuge sind auf Millionen industrieller Produktdatensätze und technischer Datenblätter trainiert. Das ist der Wortschatz, der generischen Modellen fehlt.
Der Durchlauf hatte drei Stufen. Die Klassifikation vergab einen UNSPSC-Code aus der Beschreibung, den schon vorhandenen Attributen und dem Kontext um den Datensatz. Die Attributextraktion zog Material, Maße, Betriebsangaben und OEM-Teilenummern aus dem Freitext in das Modell. Die Dublettenerkennung nutzte probabilistischen Abgleich über die Regionen und markierte Cluster zur Zusammenführung.
Ein Datensteward hat jeden KI-Vorschlag in Stapeln geprüft: annehmen, korrigieren oder ablehnen. Diese Rückmeldung hat das Modell verbessert und die Gruppe Eigentümer ihrer Stammdaten gelassen.
Freitext-Datensätze fielen von über 40 % auf unter 10 %. Die Klassifikationsgenauigkeit stieg auf über 95 %. Dublettencluster wurden zusammengeführt, und der aktive Katalog schrumpfte geschätzt um 15 bis 20 %. Die Aufnahme eines neuen Produkts, vorher Wochen aus manueller Erfassung und Gegenprüfung, dauert jetzt Tage.
Die gemeinsame Wirkung
Das Modell liefert die Struktur. Die Plattform liefert die Governance. Die KI liefert das Tempo bei Hunderttausenden von Datensätzen. Alle 12 oder mehr Regionen arbeiten jetzt aus einem Katalog. Der Einkauf kann Ausgaben analysieren, Lieferanten bündeln und über Volumen verhandeln, was mit der alten Zersplitterung unmöglich war. Die Instandhaltung findet Teile schneller, und das senkt den Stillstand der Anlagen. Ein neues Produkt, ein neuer Lieferant oder eine neue Region läuft in dasselbe Modell, dieselbe Plattform und denselben Durchlauf.
Bei einem MRO-Einkauf dieser Größe sind 1 bis 2 % Vorteil im Einkauf mehrere zehn Millionen im Jahr. Ein verlässlicher Katalog ist die Voraussetzung für diesen Vorteil.
Was zusammengehörte
Wer das Modell klärt und die Werkzeuge weglässt, bekommt eine Taxonomie, die niemand ausfüllt. Wer KI ohne das Modell einsetzt, bekommt Ausgabe, die schnell und falsch ist. Wer eine Plattform wählt, ohne die Daten und den Anreicherungsablauf, zahlt für ein System, das nicht passt. Die drei sind zusammen gelaufen, mit unabhängiger Beratung über Modell, Auswahl und KI, und genau das hat die Verschiebungen oben hervorgebracht.
Die Abwägung ist die menschliche Prüfung. Ein Datensteward, der jeden Vorschlag prüft, ist langsamer, als das Modell den Katalog ohne Aufsicht schreiben zu lassen. Genau deshalb kann ein Käufer eine Klassifikationszahl über 95 % verwenden. Ein anderer industrieller Einkäufer kann die Reihenfolge übernehmen: UNSPSC und die Attributvorlagen, dann die Plattform, dann Fach-KI mit einer Person, die das Ergebnis prüft.
Was MDM ist beschreibt das fehlende führende System, das die Regionen mit Excel aufgefangen haben. Ein PIM auswählen beschreibt den Weg von 15 Plattformen auf 3, gelaufen auf den eigenen Daten des Kunden. KI-bereite Produktdaten beschreibt, was der Datensatz braucht, bevor ein Modell ihn klassifiziert, und warum generische Verbrauchermodelle an einer Absperrklappe gescheitert sind. Produktdatenqualität und Data Governance beschreibt die Kontrolle durch Datenstewards über der KI und die Definition eines vollständigen MRO-Datensatzes, die der Gruppe gefehlt hat.
Diagnose
Brauchen Sie überhaupt ein PIM?
Ermitteln Sie Ihren Komplexitätsindex, bevor Sie Software budgetieren oder einen Systemintegrator beauftragen.
Budget
Erste TCO-Schätzung erstellen
Übersetzen Sie die Struktur Ihres Katalogs in weniger als zehn Minuten in eine Kostenspanne über drei Jahre.