Core
Het productdataproces: onboarding, verrijking en publicatie uitgelegd
Stephan Spijkers · 2026-10-20 · 12 min leestijd
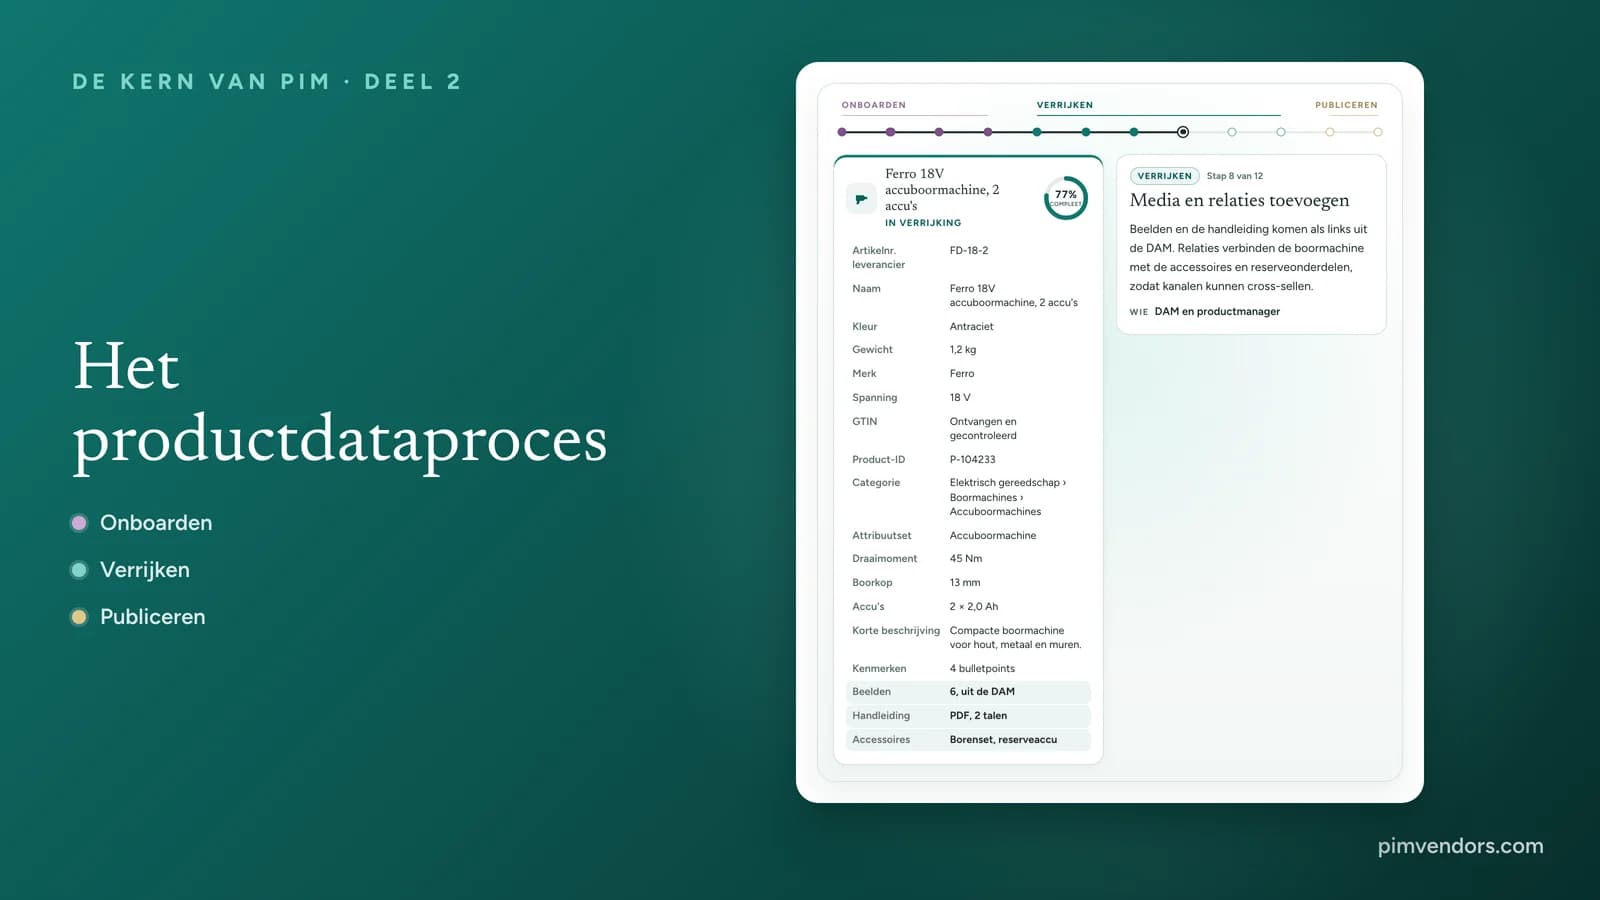
Elk product in een webshop, in een catalogus of op een marktplaats heeft dezelfde drie fasen doorlopen. De data kwam ergens vandaan, werd omgezet in iets waarmee een klant kan kiezen en kopen, en werd aan een kanaal geleverd. In veel bedrijven zijn die fasen verspreid over spreadsheets, inboxen en kopiëren en plakken. Een PIM brengt ze samen in één proces rond één productrecord. Deze gids loopt door dat proces: wat er gebeurt bij onboarding, verrijking en publicatie, wie wat doet en waar het meestal misgaat.
Het proces op één lijn
Interactief
Eén product door het hele proces
Volg een nieuwe accuboormachine van de eerste import tot het moment dat hij live staat. Druk op afspelen, of klik op een stap.
Import zonder naam
Geïmporteerd
- Artikelnr. leverancier
- FD-18-2
- Omschrijving
- ACCUBOORMACHINE 18V 2AH ANTR
- Kleur
- Antr.
- Gew. (g)
- 1200
Verzamelen
Het artikel komt uit twee bronnen: het ERP stuurt het artikelnummer en de basisdata, de leverancier stuurt een spreadsheet met al het andere. Er is nog niets opgeschoond.
WieERP en leveranciersbestand
De pijplijn hierboven volgt één nieuwe accuboormachine door twaalf stappen. Twee dingen vallen op. Het record verlaat de PIM nooit: elke stap voegt er iets aan toe of verbetert het, dus er staat nooit een "laatste versie" in iemands inbox. En volledigheid is geen lijn die alleen maar stijgt. Zodra de boormachine is geclassificeerd, weet de PIM ineens hoe een complete accuboormachine eruitziet, en de score daalt voordat hij stijgt.
Onboarding: data binnenhalen
Onboarding is alles wat er gebeurt tussen een bron en een bruikbaar productrecord. Het bepaalt meer van de datakwaliteit dan welke latere stap ook, omdat elke fout die erdoor glipt opnieuw wordt hersteld in elk kanaal dat hem ontvangt.
Waar productdata vandaan komt
De meeste producten komen tegelijk uit meer dan één bron:
- Het ERP maakt het artikelnummer, de eenheden, de prijzen en de basisdata van het artikel aan. In deel 1 van deze serie is het ERP de eigenaar van die data, en leest de PIM die.
- Leveranciers sturen spreadsheets, BMEcat- of andere catalogusbestanden, of voeren data in via een leveranciersportaal.
- Datapools zoals GS1 GDSN leveren gestandaardiseerde data van fabrikanten, in branches die ermee werken.
- PLM levert engineeringdata voor producten die een bedrijf zelf ontwerpt.
- De DAM bevat de beelden, video's en documenten.
- Oude bestanden zijn vaak de eerste bron in een PIM-project: jaren aan spreadsheets die één keer moeten worden opgeschoond.
De vier stappen van onboarding
Onboarding
Van leveranciersbestand naar schone data
Loop stap voor stap door wat er gebeurt met één rij uit de spreadsheet van een leverancier.
- Art.nrFD-18-2Artikelnr. leverancierFD-18-2
- EAN(leeg)GTINOntbreektTeruggestuurd naar de leverancier
- OmschrijvingACCUBOORMACHINE 18V 2AH ANTRVoorlopige naamAccuboormachine 18V 2Ah, antraciet
- KleurAntr.KleurAntraciet
- Gew. (g)1200Gewicht1,2 kg
- Afm. LxBxH250x80x210Lengte · Breedte · Hoogte250 · 80 · 210 mm
- Volt18Spanning18 V
Fase 1 van 4
Mappen
Elke kolom wordt gekoppeld aan een attribuut in de PIM. Eén kolom kan meerdere attributen vullen, en sommige kolommen zijn helemaal niet nodig.
- Verzamelen. Data wordt geïmporteerd via een bestand, een API, een datapool of een portaal, en komt in een stagingomgeving terecht in plaats van direct in de catalogus.
- Mappen. Elk veld in de bron wordt gekoppeld aan een attribuut in het datamodel van de PIM. De mapping wordt per bron opgeslagen, zodat het volgende bestand zichzelf mapt.
- Valideren en opschonen. Regels rekenen eenheden om, schrijven afkortingen uit, koppelen waarden aan waardelijsten, splitsen gecombineerde velden en controleren formaten en verplichte velden.
- Matchen. De PIM controleert of het product al bestaat, op GTIN, leveranciersnummer of een fuzzy match op naam en specificaties, en voegt het samen met een bestaand record of maakt een nieuw record aan.
Staging en quarantaine
Geïmporteerde data hoort niet direct in de catalogus. Een stagingomgeving houdt nieuwe data vast tot die door de validatie komt, en een quarantaine bewaart wat afvalt, met de reden erbij. De datasteward werkt dan aan de uitzonderingen in plaats van elke rij te controleren. Dat is het verschil tussen duizend producten onboarden op één dag en ze onboarden in een maand.
Maak leveranciers onderdeel van het proces
De goedkoopste correctie is die de leverancier maakt voordat hij het bestand verstuurt. Geef leveranciers een sjabloon of een portaal dat je datamodel volgt, vertel ze welke attributen verplicht zijn voor hun categorie, en stuur validatiefouten automatisch terug. Heeft je branche een datapool of een classificatiestandaard zoals ETIM of GS1, gebruik die dan: een leverancier die al in dat formaat levert, heeft geen eigen mapping nodig. Ons artikel over waarom onvolledige productdata begint bij het leveranciersbestand gaat hier dieper op in.
Verrijking: van data naar content die verkoopt
Bij verrijking wordt een artikel een product. Hier zit ook het meeste werk, en werken de meeste mensen.
Eerst classificeren
Classificatie geeft het product zijn plek: in je eigen categorieboom en, als je die gebruikt, in een standaard zoals GS1 GPC, ETIM of ECLASS. De klasse bepaalt de attribuutset: de lijst met attributen die bij dit soort product horen, en welke daarvan verplicht zijn. Daarom komt classificatie eerst. Zolang een product niet is geclassificeerd, kan niemand zeggen wat compleet voor dat product betekent. Deel 3 van deze serie legt uit hoe klassen, attribuutsets en overerving in elkaar passen, en onze gids over GS1, ETIM en ECLASS behandelt de standaarden.
Specificeren, beschrijven en laten zien
Met de attribuutset op zijn plek wordt het record in drie lagen ingevuld:
- Specificaties: de technische attributen van de klasse, uit het datablad van de leverancier, uit PLM of van de productmanager.
- Beschrijvingen: een naam die werkt in zoekopdrachten, korte en lange beschrijvingen, bulletpoints met de kenmerken en zoekwoorden. Specificaties vertellen wat een product is; beschrijvingen vertellen waarom iemand het zou moeten kopen.
- Media: beelden, video's, handleidingen en certificaten, gekoppeld vanuit de DAM in plaats van gekopieerd.
Relaties en varianten
Producten staan zelden op zichzelf. Relaties verbinden een product met zijn accessoires, reserveonderdelen, opvolgers en alternatieven, en daar draaien cross-selling en vragen over compatibiliteit op. Varianten groeperen maten en kleuren onder één product, zodat je gedeelde content één keer schrijft. Allebei horen ze bij het datamodel, en allebei komen ze aan bod in deel 3.
Lokaliseren
Elke markt krijgt een eigen taalversie, en soms eigen eenheden, eigen regelgeving en een eigen assortiment. Specificaties blijven meestal gelijk; namen, verkoopteksten, juridische teksten en maateenheden volgen de markt. Een PIM houdt alle taalversies op hetzelfde record, dus een wijziging in een specificatie bereikt elke taal tegelijk en alleen de tekst moet nog worden vertaald.
Waar AI helpt
AI hoort inmiddels bij verrijking in de meeste PIM's: beschrijvingen opstellen, attributen uit pdf's van leveranciers halen, classificaties voorstellen en vertalen. Het werkt het best op een schoon model met duidelijke regels, en de output moet nog steeds worden gecontroleerd op feiten, toon en compliance. Onze gids over wat AI in een PIM echt doet laat zien waar het werkt en waar het breekt.
Volledigheid is per kanaal
Interactief
Compleet voor welk kanaal?
Elk kanaal heeft andere attributen nodig, dus één product kan klaar zijn voor print en nog ver van klaar voor een marktplaats. Vul attributen in of maak ze leeg, en kijk wat er per kanaal gebeurt.
- WMPD
- WMPD
- WMPD
- WMPD
- WMPD
- WMPD
- WMPD
- WMPD
- WMPD
- WMPD
- WMPD
Eén volledigheidsscore is misleidend. De webshop heeft lange beschrijvingen en extra beelden nodig, de marktplaats bulletpoints en een GTIN, de printcatalogus korte tekst, de datapool gewichten, afmetingen en veiligheidsdocumenten. Een PIM meet de volledigheid per kanaal, en vaak per taal, en blokkeert publicatie naar een kanaal tot aan de eisen van dat kanaal is voldaan. Probeer het hierboven: hetzelfde product is klaar voor print en nog ver van klaar voor de marktplaats.
Review en goedkeuring
Voordat er iets wordt gepubliceerd, controleren kwaliteitsregels het record en keurt een mens het goed. In kleine teams is dat één reviewstap; in grotere teams stuurt een workflow het product langs specialisten en goedkeurders. Onze gids over productdatakwaliteit en governance behandelt de regels en rollen erachter.
Publicatie: één record, elk kanaal
Bij publicatie komt het goedgekeurde record bij de kanalen. De taak van de PIM is hier niet om overal dezelfde data naartoe te sturen, maar om elk kanaal precies te geven wat het nodig heeft, in het eigen formaat en volgens de eigen regels, vanuit hetzelfde record.
Publicatie
Eén record, vijf versies
Hetzelfde goedgekeurde record wordt in elk kanaal iets anders. Kies een kanaal en wijs een veld aan om te zien waar het terechtkomt.
Goedgekeurd record
Wijs een veld aan om het te volgen
Ferro Accuboormachine 18V, 45 Nm, 13 mm boorkop, 2 × 2,0 Ah accu's
Categorie: Gereedschap › Elektrisch gereedschap › Boormachines
• KRACHTIG: 45 Nm draaimoment voor hout en metaal
• VEELZIJDIG: 13 mm snelspanboorkop
• DIRECT AAN DE SLAG: twee accu's van 2,0 Ah meegeleverd
• LICHT: slechts 1,2 kg
Product-ID: GTIN 2000000000039
Wat er voor dit kanaal veranderde
- Titel opgebouwd uit merk, type en belangrijkste specificaties, in de volgorde van de marktplaats
- Gemapt naar de eigen categorieboom van de marktplaats
- Bulletpoints in de stijl van de marktplaats; zonder GTIN geen listing
Kanaaleisen en mapping
Elk kanaal heeft eigen attribuutnamen, een eigen categorieboom, eigen waardelijsten en eigen limieten. Marktplaatsen bouwen titels op volgens een vast patroon en eisen identifiers. Datapools gebruiken een eigen attribuutstructuur en codelijsten voor eenheden. Print heeft korte tekst van een vaste lengte nodig. De PIM houdt per kanaal een mapping bij die het record vertaalt naar de versie van dat kanaal, zodat niemand een product voor elke bestemming met de hand herschrijft. Specifiek voor marktplaatsen is er onze gids over PIM en marktplaatsen.
Hoe de data reist
- API's leveren productdata aan je eigen webshop, apps en front-ends, vaak in realtime.
- Feeds sturen volgens een vast schema bestanden naar marktplaatsen, vergelijkingssites en retailers.
- Datapools verspreiden gestandaardiseerde data naar retailers in branches zoals levensmiddelen, gezondheid en doe-het-zelf.
- Print en documenten worden vanuit sjablonen gegenereerd voor catalogi, databladen en prijslijsten.
- Machineleesbare endpoints laten AI-shoppingagents en antwoordmachines gestructureerde productdata lezen. Onze gids over AI-klare productdata legt uit wat ze nodig hebben.
De meeste kanalen ontvangen wijzigingen als delta in plaats van elke keer de volledige catalogus. Dat houdt feeds snel en maakt duidelijk wat er is veranderd.
Sluit de lus
Kanalen praten terug. Een marktplaats weigert een listing, een retailer meldt een verkeerd gewicht, een datapool stuurt een validatiefout terug, een klant stelt drie keer dezelfde vraag. Elk daarvan is verrijkingswerk. In een goed proces bereikt de feedback de PIM, komt die op de takenlijst van de juiste persoon terecht, en wordt het gecorrigeerde record opnieuw gepubliceerd. Daarom is publicatie het begin van de volgende ronde, niet het eindpunt.
Workflow en governance door het hele proces
Een product doorloopt statussen: concept, in verrijking, in review, goedgekeurd, gepubliceerd en, aan het eind van zijn leven, uitgefaseerd. Elke wijziging na publicatie, van een update van de leverancier tot feedback uit een kanaal, stuurt het product voor die wijziging terug naar verrijking en opnieuw door de review. De statussen maken het proces zichtbaar: iedereen ziet wat er wacht, op wie en hoe lang al.
Governance bepaalt wie wat mag doen in elke status. De basis:
- Eén eigenaar per attribuut. De productmanager is eigenaar van de specificaties, marketing van de teksten, het DAM-team van de media en de kanaalmanager van de kanaalversies.
- Eerst regels, dan mensen. Validatieregels vangen af wat automatisch kan worden afgevangen, zodat reviewers hun tijd besteden aan oordelen en niet aan ontbrekende eenheden.
- Eerst goedkeuring, dan publicatie. Niets bereikt een kanaal zonder aan de eisen van dat kanaal te voldoen en, waar het ertoe doet, zonder de goedkeuring van een mens.
- Een audittrail. Bij elke wijziging wordt vastgelegd wie haar deed, wanneer en vanuit welke bron.
Het proces meten
Een proces dat je niet meet, kan niet sneller worden. De metingen die het meest tellen:
- Time-to-market: van de eerste import tot live op elk kanaal.
- Volledigheid per kanaal: hoeveel producten aan de eisen van elk kanaal voldoen.
- First-time-right-percentage: hoeveel producten door de validatie en de review komen zonder terug te gaan.
- Afwijzingen door kanalen: hoeveel listings of datapoolberichten met fouten terugkomen, en waarom.
- Kwaliteit van leveranciersdata: hoeveel problemen de bestanden van elke leverancier veroorzaken. Dat laat zien waar je moet investeren in sjablonen of onboarding.
Waar het proces breekt
Het proces inrichten in een PIM
Breng de bronnen en de kanalen in kaart
Zet elke bron van productdata op een rij en elk kanaal waar die data naartoe gaat, met de formaten en de eigenaren aan beide kanten. Dit is de schets van je proces.
Leg het datamodel en de eisen per kanaal vast
Spreek de classificatie af, de attribuutsets en welke attributen elk kanaal verplicht stelt. Volledigheid kun je alleen tegen deze eisen meten.
Bouw de onboarding per bron
Maak voor elke bron een mapping en validatieregels, een stagingomgeving voor nieuwe data en een route terug naar de leverancier voor wat afvalt.
Richt verrijkingsworkflows en eigenaren in
Geef elke attribuutgroep een eigenaar, stuur producten langs de juiste mensen en voeg een review en goedkeuring toe vóór publicatie.
Koppel de kanalen en de feedback
Bouw de kanaalmappings, kies per kanaal een API, feed, datapool of print, en zorg dat afwijzingen en vragen als taken terugkomen in de PIM.
Waar je op let bij een PIM
Het proces stelt specifieke eisen aan het systeem. Vraag bij het vergelijken van PIM's om deze punten met je eigen data te laten zien:
- Import en mapping: opgeslagen mappings per leverancier, transformatieregels, staging en quarantaine, en een leveranciersportaal of datapoolkoppeling als je die nodig hebt.
- Datamodel en classificatie: attribuutsets per klasse, overerving en varianten, en ondersteuning voor de standaarden in je branche.
- Volledigheid en validatie: regels per kanaal en per taal, waarbij publicatie wordt geblokkeerd tot aan de eisen is voldaan.
- Workflow: statussen, eigenaren, taken en goedkeuringen die passen bij jouw team, niet bij de demo van de PIM-leverancier.
- Syndicatie: kant-en-klare connectors voor je kanalen, kanaalmappings die je zelf kunt onderhouden, en een manier om feedback uit de kanalen te verwerken.
Ons overzicht van PIM-functies en -mogelijkheden behandelt de volledige lijst, en de gids voor PIM-implementatie laat zien hoe je het proces in een project inricht.
Hoe je verder gaat
Frequently asked questions
Wat is onboarding van productdata?
Onboarding is hoe productdata in de PIM komt: je verzamelt de data uit het ERP, van leveranciers, uit datapools en uit andere bronnen, mapt die naar het datamodel van de PIM, schoont en valideert ze, en matcht ze met producten die al bestaan. Goede onboarding houdt slechte data aan de deur tegen, in plaats van die later in elk kanaal te herstellen.
Wat is verrijking van productdata?
Verrijking maakt van basale artikeldata content die verkoopt en aan de regels voldoet: classificatie, technische attributen, namen en beschrijvingen, beelden en documenten, relaties met andere producten, en vertalingen. Er zijn meestal meerdere teams bij betrokken, en steeds vaker AI, met een review en goedkeuring voordat er iets wordt gepubliceerd.
Wat is syndicatie van productdata?
Syndicatie is het publiceren van productdata naar externe kanalen, in het formaat dat elk kanaal vraagt: marktplaatsen, retailers, datapools zoals GS1 GDSN, print en AI-agents. De PIM houdt één record bij en maakt voor elke bestemming een eigen kanaalversie. Daarna verwerkt hij de feedback die de kanalen terugsturen.
Wat betekent volledigheid in een PIM?
Volledigheid meet hoeveel van de verplichte attributen van een product zijn ingevuld. Je meet het per kanaal en vaak per taal, omdat elk kanaal andere attributen vraagt. Een product kan tegelijk compleet zijn voor print en onvolledig voor een marktplaats.
Wie is verantwoordelijk voor het verrijken van productdata?
Dat is een gedeelde taak. Productmanagers zijn eigenaar van de technische attributen, marketing- of contentteams van de teksten, het DAM-team van de media, vertalers van de talen en kanaalmanagers van de kanaalversies. Governance laat het werken: elk attribuut heeft één eigenaar, en een workflow stuurt producten naar de juiste persoon en naar iemand die goedkeurt.
Kan AI productdata automatisch verrijken?
AI kan beschrijvingen opstellen, attributen uit leveranciersdocumenten halen, classificaties voorstellen en vertalen. Het werkt het best op een schoon datamodel met duidelijke regels, en de output moet nog steeds worden gecontroleerd op feiten, toon en compliance voordat hij wordt gepubliceerd.
Hoe versnel je de onboarding van leveranciers?
Geef leveranciers een sjabloon of portaal dat je datamodel volgt, sla de mapping per leverancier op zodat het volgende bestand zichzelf mapt, valideer bij de import, stuur problemen automatisch terug naar de leverancier en gebruik datapools als je branche er een heeft.
Wat is het verschil tussen publiceren en syndicatie?
Publiceren betekent meestal dat je goedgekeurde productdata beschikbaar maakt voor je eigen kanalen, zoals de webshop en print. Syndicatie betekent dat je de data naar kanalen stuurt die je niet zelf beheert, zoals marktplaatsen, retailers en datapools, in hun formaten en volgens hun regels. In de praktijk doet de PIM allebei vanuit hetzelfde record.
Diagnose
Heb je eigenlijk wel een PIM nodig?
Draai eerst de complexiteitsindex voordat je software budgetteert of een systeemintegrator inhuurt.
Budget
Maak een eerste TCO-berekening
Zet de vorm van je catalogus in minder dan tien minuten om in een kostenrange voor drie jaar.