Core
Das Produktdatenmodell: Stammdaten, Hierarchien, Varianten und SKUs erklärt
Stephan Spijkers · 2026-10-20 · 15 Min. Lesezeit
Jedes PIM baut auf einem Datenmodell auf: den Entscheidungen darüber, welche Datensätze es gibt, welche Attribute sie tragen, wie sie zusammenhängen und wo jeder Wert liegt. Mit einem guten Modell ist ein neues Produkt in Minuten angelegt, und eine Korrektur erreicht jeden Kanal. Mit einem schwachen Modell kopieren Teams dieselbe Beschreibung in vierzig Varianten, streiten darüber, wem das Gewicht gehört, und stellen beim Launch fest, dass der Marktplatz ein Attribut verlangt, das niemand angelegt hat.
Dieser Leitfaden erklärt die Bausteine an einem durchgehenden Beispiel: dem Trail Runner 2, einem Trailrunning-Schuh der fiktiven Marke Fjellstep. Teil 1 dieser Serie hat die Systeme rund um ein PIM abgebildet, und Teil 2 hat die Daten durch Onboarding, Anreicherung und Veröffentlichung begleitet. Dieser Teil öffnet das PIM selbst und betrachtet die Struktur, die all diese Arbeit mit Inhalt füllt.
Stammdaten, Rich Content und Metadaten
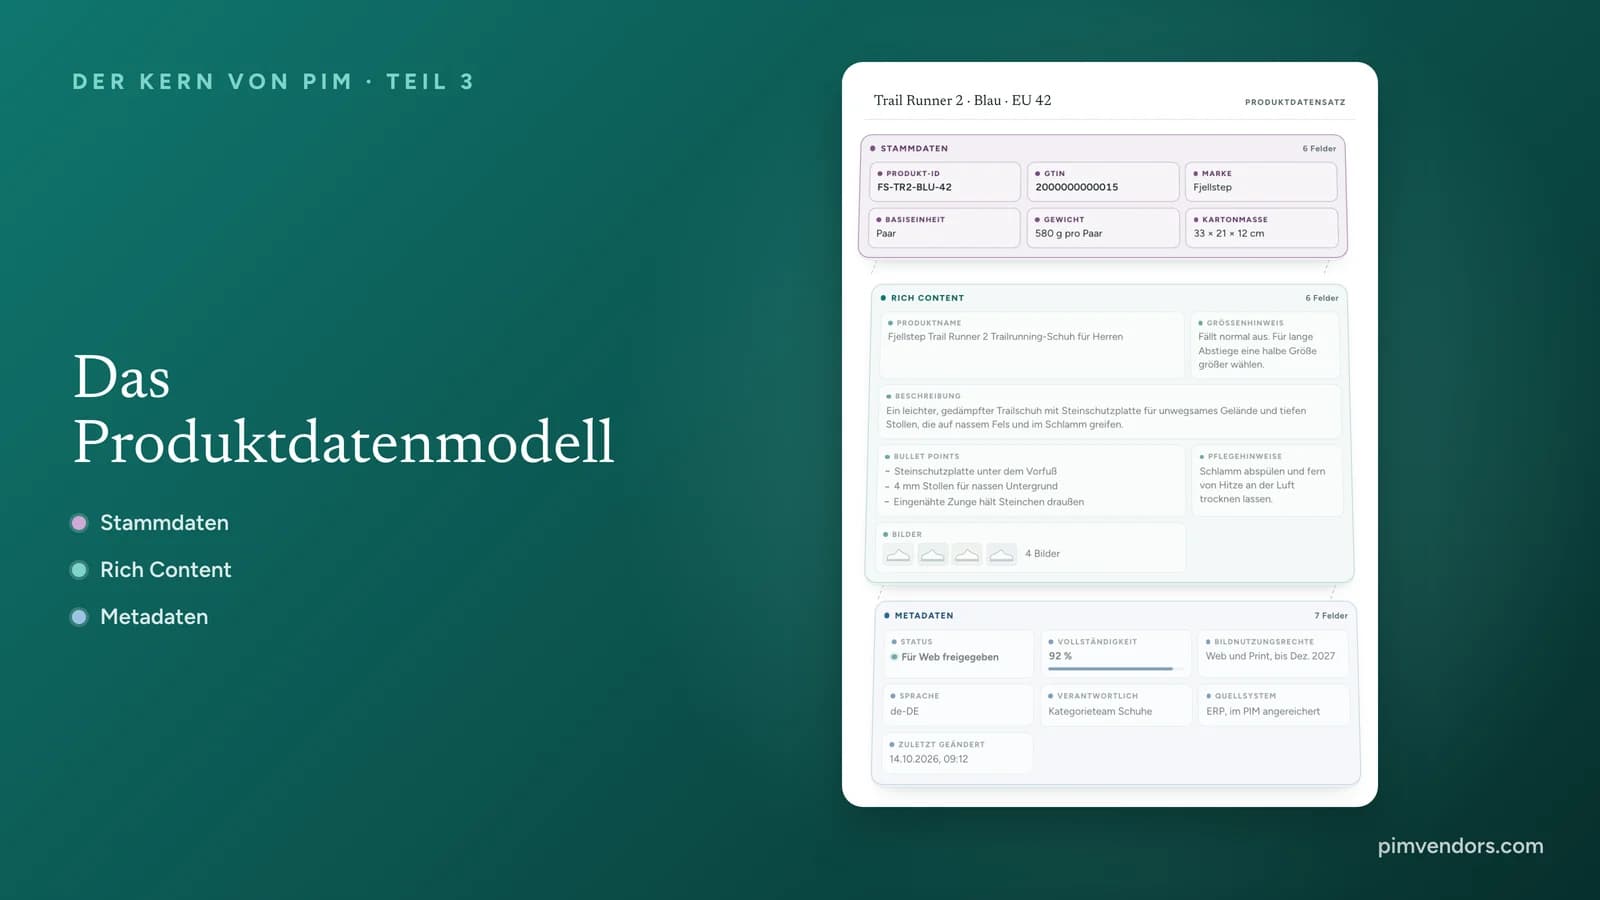
Öffnen Sie einen beliebigen Produktdatensatz in einem PIM, und Sie sehen eine Maske voller Felder. Darunter gehören diese Felder zu drei verschiedenen Schichten, und wo sie vermischt werden, entsteht mancher Streit um Zuständigkeiten.
Stammdaten identifizieren das Produkt: die Artikelnummer, die GTIN, die Marke, die Basiseinheit, das Gewicht und die Abmessungen. Das sind Fakten, keine Meinungen, und jedes System, das mit dem Produkt arbeitet, braucht genau dieselben Werte. Das Lager braucht das Gewicht, das ERP die Einheit, der Marktplatz die GTIN. Rich Content, also die angereicherten Produktdaten, erklärt und verkauft das Produkt: den Namen, den Kunden sehen, die Beschreibung, die Bullet Points mit den Merkmalen, Bilder, Größentabellen und Pflegehinweise. Er wird für Menschen geschrieben, pro Markt übersetzt und pro Kanal aufbereitet. Metadaten sind Daten über die Daten: woher ein Wert stammt, wer für ihn verantwortlich ist, wann er zuletzt geändert wurde, wie vollständig der Datensatz ist und ob die Bilder noch verwendet werden dürfen.
Interaktiver Datensatz
Ein Datensatz, drei Schichten
Wählen Sie eine Schicht, um zu sehen, welche Felder dazugehören. Zerlegen Sie den Datensatz dann, um die drei Schichten voneinander zu trennen.
Produktdatensatz
Trail Runner 2 · Blau · EU 42
- Steinschutzplatte unter dem Vorfuß
- 4 mm Stollen für nassen Untergrund
- Eingenähte Zunge hält Steinchen draußen
Marke, Produkt und Codes sind erfundene Beispiele.
Was das Produkt ist
Stammdaten
Die Fakten, die das Produkt identifizieren: Codes, Marke, Einheit, Gewicht und Größe. Jedes System, das mit dem Produkt arbeitet, braucht genau dieselben Werte. Deshalb werden sie einmal angelegt, meist im ERP oder in einem MDM, und überallhin kopiert.
- Meist verantwortlich
- Ein Stammdatenteam oder das Produktmanagement, im ERP oder im MDM
- Änderungshäufigkeit
- Selten. Beim Anlegen des Produkts gesetzt und nur über einen kontrollierten Änderungsantrag geändert
- Weitere Beispiele
Wer für welche Schicht verantwortlich ist
Stammdaten entstehen meist außerhalb des PIM. In der Sprache von Teil 1 ist das ERP oder ein MDM ihr führendes System (System of Record), und das PIM liest eine Kopie. Ein Gewicht, das im PIM korrigiert wird und nicht im ERP, ergibt zwei Gewichte und ein Lager, das die falschen Versandkosten berechnet. Wo es ein MDM gibt, hält es eine saubere Identität des Produkts im gesamten Unternehmen. Wie das gelingt, erklären die Grundprinzipien des Master Data Management. Rich Content ist die Schicht, für die es ein PIM überhaupt gibt. Marketing-, E-Commerce- und Kategorieteams verantworten sie, oft mit ersten Entwürfen von Lieferanten und Agenturen. Metadaten erzeugt größtenteils das PIM selbst, wobei Data Stewards für den Workflow, die Qualitätsregeln und die Asset-Rechte zuständig sind.
Die drei Schichten ändern sich außerdem unterschiedlich schnell. Stammdaten werden einmal gesetzt und nur über einen kontrollierten Änderungsantrag geändert. Rich Content ändert sich jede Saison und jedes Mal, wenn ein Kanal etwas Neues verlangt. Metadaten ändern sich mit jeder Bearbeitung, jedem Import und jeder Freigabe. Deshalb funktioniert eine einzige Zugriffsregel für den ganzen Datensatz nie: Wer eine Beschreibung jede Woche neu schreiben darf, sollte keine GTIN ändern können.
Metadaten machen einen Datensatz vertrauenswürdig
Metadaten tauchen selten auf einer Produktseite auf, doch ohne sie funktioniert das PIM nicht. Vollständigkeitswerte entscheiden, ob ein Produkt in einem Kanal veröffentlicht werden darf. Der Workflow-Status entscheidet, wer als Nächstes daran arbeitet. Die Datenherkunft (Lineage) zeigt Ihnen, dass ein Wert letzten Dienstag aus einer Lieferantendatei kam und nicht von Ihrem eigenen Team. Nutzungsrechte und Ablaufdaten verhindern, dass ein Bild veröffentlicht wird, nachdem seine Lizenz abgelaufen ist. Wenn es heißt, ein PIM „steuert“ Produktdaten, ist meist diese Schicht gemeint. Produktdatenqualität und Data Governance behandelt die Regeln, die darauf aufsetzen.
Hierarchische und relationale Modelle
Datensätze in einem PIM sind auf zwei grundlegende Arten verbunden. In einer Hierarchie hat jeder Datensatz genau einen übergeordneten Datensatz: Die Kategorie enthält das Produkt, das Produkt seine Farben, jede Farbe ihre Größen. In einem relationalen Modell sind Datensätze über benannte, gerichtete Beziehungen miteinander verknüpft, und ein Datensatz kann viele Verknüpfungen unterschiedlicher Typen haben. Der Schuh wird von einer Marke hergestellt, ersetzt ein älteres Modell und hat Zubehör, und dieselbe Einlegesohle kann Zubehör für zwei verschiedene Schuhe sein.
Interaktives Diagramm
Dieselben Datensätze, zwei Formen
Wechseln Sie zwischen einer strikten Hierarchie und einem Netz typisierter Beziehungen. Die Datensätze bleiben dieselben. Nur die Art, wie sie verbunden sind, ändert sich.
Hierarchie
Hierarchie: je ein übergeordneter Datensatz
Jeder Datensatz hat genau einen übergeordneten Datensatz. Die Kategorie enthält das Produkt, das Produkt seine Farben, jede Farbe ihre Größen. Ein Wert, der weit oben im Baum gesetzt wird, wird an alles darunter vererbt, sodass eine Änderung jede Größe erreicht.
- Geeignet für
- Wo die Grenze liegt
- Ein Baum kann nicht ausdrücken, dass die Gamasche zu diesem Schuh passt, dass eine Einlegesohle zu zwei Modellen passt oder dass der Trail Runner 2 den Trail Runner 1 ersetzt. Dafür bräuchte es jeweils einen zweiten übergeordneten Datensatz, und ein Baum erlaubt nur einen.
Die meisten PIMs kombinieren beides: eine Hierarchie für Kategorien, Produktmodelle und Varianten und typisierte Beziehungen für alles, was quer dazu verknüpft ist.
Wofür sich welche Form eignet
Eine Hierarchie ist die richtige Form, wenn ein Datensatz einen natürlichen übergeordneten Datensatz hat und dessen Werte teilen soll. Das gilt für den Kategoriebaum, mit dem Produkte klassifiziert werden, für das Produktmodell mit seinen Varianten und für organisatorische Bäume wie Produktlinien. Ihre Stärke ist die Vererbung: Ein Wert, der weit oben im Baum gesetzt wird, erreicht alles darunter.
Ein relationales Modell ist die richtige Form für alles, was quer zum Baum verknüpft ist. Zubehör und Cross-Selling, Kompatibilität („dieser Akku passt in diese sechs Bohrschrauber“), Ersatzteile, Nachfolger und Ersatzprodukte, Bundles und Sets sowie Verknüpfungen zu Dokumenten wie Bedienungsanleitungen und Sicherheitsdatenblättern sind alles Beziehungen. Eine Beziehung hat einen Typ und eine Richtung, und sie kann eigene Attribute tragen: die Menge jedes Teils in einem Set oder einen Hinweis, dass ein Adapter nötig ist. Für Produkte, die aus Teilen zusammengesetzt werden, erklärt Stücklisten in PIM und ERP, wo die Beziehung endet und die Fertigungsstruktur beginnt.
Die meisten PIMs kombinieren beides
In der Praxis brauchen Sie beide Formen gleichzeitig und meist mehr als eine Hierarchie. Ein typisches PIM führt eine Hauptklassifizierung, die über die Attribute jedes Produkts entscheidet, getrennte Navigationsbäume für jeden Onlineshop oder Markt und die Produktmodelle mit ihren Varianten, und daneben eine Reihe von Beziehungstypen. Ein Produkt sitzt an genau einer Stelle in der Hauptklassifizierung, kann aber in vielen Navigationsbäumen erscheinen. Beides getrennt zu halten ist eine der nützlichsten Modellierungsentscheidungen überhaupt: Das Merchandising-Team kann das Menü des Onlineshops umbauen, ohne ein einziges Attribut anzufassen.
Vererbung und Beziehungen
Vererbung macht einen großen Katalog beherrschbar. Das Produktmodell hält alles, was seine Ausführungen gemeinsam haben: Marke, Obermaterial, Sprengung (Drop), Beschreibung, Pflegehinweise, die meisten Bilder. Varianten erben diese Werte und ergänzen nur, was sie unterscheidet, etwa die Farbe. Größen erben von ihrer Farbe und ergänzen ihre eigene Größe und GTIN. Ein Schuh in zwei Farben mit jeweils drei Größen ergibt neun Datensätze mit einer einzigen Beschreibung, die gepflegt werden muss.
Probieren Sie es aus
Einmal ändern, überall sehen
Ändern Sie das Obermaterial am Produktmodell und verfolgen Sie, wie es an jede Farbe und jede Größe weitergegeben wird. Überschreiben Sie es dann bei Schwarz.
Produktmodell
Trail Runner 2
- Marke
- Fjellstep
- Obermaterial
- Engineered Mesh
- Sprengung
- 6 mm
- Beschreibung
- Leichter Trailschuh mit Steinschutzplatte
Variante
Blau
- Farbe
- Blau
- Obermaterial
- Engineered Mesh
EU 41
Engineered Mesh
EU 42
Engineered Mesh
EU 43
Engineered Mesh
Variante
Schwarz
- Farbe
- Schwarz
- Obermaterial
- Engineered Mesh
EU 41
Engineered Mesh
EU 42
Engineered Mesh
EU 43
Engineered Mesh
Einmal gesetzt, nach unten vererbt
Das Produktmodell hält, was alle Ausführungen gemeinsam haben. Varianten erben diese Werte und ergänzen nur, was sie unterscheidet, etwa die Farbe. Größen erben von ihrer Farbe. Korrigieren Sie einen Wert oben, und niemand muss acht Datensätze bearbeiten.
Engineered Mesh hat beide Farben und alle sechs Größen erreicht.
Beziehungen funktionieren anders. Eine Beziehung verknüpft zwei Datensätze, sie kopiert keine Werte. Die Gamasche, die als Zubehör für diesen Schuh verknüpft ist, behält ihr eigenes Material, und eine Änderung hier erreicht sie nie.
Überschreibungen: die Ausnahme, nicht die Gewohnheit
Manchmal unterscheidet sich eine Variante tatsächlich. Die schwarze Ausführung bekommt ein wasserdichtes Obermaterial, oder eine Farbe wird mit einer anderen Einlegesohle geliefert. Eine Überschreibung setzt einen lokalen Wert an diesem Datensatz, und der geerbte Wert erreicht weder ihn noch die Datensätze darunter. Überschreibungen sind ebenso nützlich wie gefährlich. Jede ist ein Wert, an den jemand denken muss, und ein Team, das großzügig überschreibt, hat bald ein Modell, in dem nichts mehr vererbt wird. Ein gutes PIM zeigt klar, welche Werte geerbt und welche lokal gesetzt sind, und lässt Sie Überschreibungen gesammelt auflisten und zurücksetzen.
Die Faustregel ist einfach: Setzen Sie jeden Wert auf der höchsten Ebene, auf der er für jeden Datensatz darunter zutrifft. Gilt er für das ganze Modell, setzen Sie ihn am Modell. Gilt er für eine Farbe, setzen Sie ihn bei der Farbe.
Beziehungen vererben nicht
Eine Beziehung verknüpft zwei Datensätze, kopiert aber nichts zwischen ihnen. Wird die Gamasche als Zubehör für den Trail Runner 2 verknüpft, behält die Gamasche ihr eigenes Material, ihren eigenen Preis und ihre eigene Beschreibung. Eine Änderung am Schuh erreicht die Gamasche nie. Genau das wollen Sie: Das Zubehör ist ein eigenständiges Produkt mit einem eigenen Verantwortlichen.
Daraus folgen zwei praktische Punkte. Erstens: Legen Sie fest, wo eine Beziehung liegt. Eine Beziehung am Produktmodell gilt je nach PIM für jede Variante oder eben nicht. Prüfen Sie also, wie Ihr PIM das handhabt, bevor Sie Tausende von Verknüpfungen laden. Zweitens: Legen Sie fest, ob Beziehungen in beide Richtungen wirken. „Zubehör für“ und „hat Zubehör“ sind dieselbe Verknüpfung, von zwei Seiten betrachtet. Beide Richtungen von Hand zu pflegen verdoppelt die Arbeit und lädt zu Fehlern ein. Achten Sie deshalb auf ein PIM, das die Gegenrichtung automatisch synchron hält.
Wie die Klassifizierung das Attributset bestimmt
Die Klassifizierung ordnet jedes Produkt in einen Baum von Klassen ein, und diese Position entscheidet, welche Attribute das Produkt erhält. Die Wurzel des Baums steuert die Attribute bei, die jedes Produkt braucht, etwa eine ID, einen Namen, eine Marke und ein Hauptbild. Eine Produktfamilie ergänzt, was die Familie gemeinsam hat: Alle Schuhe brauchen ein Größensystem und ein Obermaterial. Die Klasse ergänzt, was nur sie braucht: Ein Trailrunning-Schuh hat eine Sprengung und eine Profiltiefe, ein Akku-Bohrschrauber ein Drehmoment und eine Bohrfutter-Spannweite, ein Sofa eine Sitzhöhe. Das Attributset des Produkts ist alles, was sich entlang seines Pfads sammelt.
Interaktiver Baukasten
Die Klasse bestimmt die Attribute
Wählen Sie ein Produkt. Seine Position in der Klassifizierung entscheidet, welche Attribute es erhält: einige für jedes Produkt, weitere aus seiner Familie und die spezifischsten aus seiner Klasse.
Klassifizierungspfad
- Alle Produkte
- Schuhe
- Laufschuhe
- Trailrunning-Schuhe
Lässt sich einer Standardklasse in GS1 GPC zuordnen
Attributset
15 Attribute, davon 11 Pflicht
GlobalFür jedes Produkt
- Produkt-IDTextPflicht
- ProduktnameText, je SprachePflicht
- MarkeListePflicht
- BeschreibungFormatierter Text, je SprachePflicht
- HauptbildAsset-LinkPflicht
- UrsprungslandListeOptional
FamilieAus der Familie: Schuhe
- GrößensystemListePflicht
- ObermaterialListePflicht
- GeschlechtListePflicht
- VerschlussListeOptional
KlasseAus der Klasse: Trailrunning-Schuhe
- SprengungZahl, mmPflicht
- ProfiltiefeZahl, mmPflicht
- Gewicht pro SchuhZahl, gPflicht
- SteinschutzplatteJa/NeinOptional
- Wasserdichte MembranJa/NeinOptional
Ihre eigenen Klassen lassen sich einem Standard zuordnen, etwa GS1 GPC für Konsumgüter oder ETIM für technische Produkte. So lesen Lieferanten, Datenpools und Kunden dieselben Attribute.
Pflicht, optional und pro Kanal
Das Attributset legt auch fest, welche Attribute Pflicht sind. Damit wird die Klassifizierung zur Grundlage für die Vollständigkeit: Ein Produkt lässt sich erst bewerten, wenn das PIM weiß, zu welcher Klasse es gehört. Die Anforderungen unterscheiden sich oft je Kanal, weil ein Marktplatz Attribute verlangen kann, die Ihr eigener Onlineshop gar nicht anzeigt. Teil 2 zeigt, wie Klassifizierung und Vollständigkeit bei der Anreicherung zusammenwirken.
Attributtypen sind genauso wichtig. Eine Sprengung, die als Zahl in Millimetern gespeichert ist, lässt sich filtern, sortieren, umrechnen und prüfen. Dieselbe Sprengung als Freitext („6mm“, „6 mm“, „ca. 6“) nicht. Listen mit festen Werten, Zahlen mit Einheiten und Ja/Nein-Felder sorgen dafür, dass Filter, Vergleiche und Kanal-Feeds funktionieren.
Eigene Klassen und die Standards
Die meisten Unternehmen klassifizieren mit ihrem eigenen Baum, weil er abbildet, wie sie einkaufen, verkaufen und ihre Teams organisieren. Ihre Handelspartner erwarten dagegen oft einen Standard. GS1 GPC (Global Product Classification) wird für Konsumgüter und in GS1-Datenpools verwendet. ETIM beschreibt technische Produkte für den Großhandel, und ECLASS ist im industriellen Einkauf verbreitet. Wenn Sie jede Ihrer Klassen der passenden Standardklasse zuordnen, können Lieferanten Daten in einer Form liefern, die Sie importieren können, und Kunden lesen Ihre Attribute ohne Übersetzungstabelle. Produktklassifikation und Datenstandards erklärt jeden Standard und wann er sich eignet.
Klassifizierung ist nicht Navigation
Die Hauptklassifizierung entscheidet über die Attribute. Die Kategorien in einem Onlineshop entscheiden, wo ein Produkt erscheint und wie Käufer stöbern. Sie beantworten unterschiedliche Fragen und ändern sich unterschiedlich schnell, führen Sie sie deshalb als getrennte Hierarchien. Ein Produkt, das einmal als Trailrunning-Schuh klassifiziert ist, kann unter „Laufen“, „Neuheiten“ und „Geschenke für Wanderer“ erscheinen, ohne dass sich an seinen Attributen etwas ändert.
Entität, Produkt, Variante, SKU und Artikel
Dieselben Wörter bedeuten für verschiedene Teams Verschiedenes, und viele Missverständnisse in Projekten beginnen genau hier. Wenn jemand sagt: „Wir haben Zehntausende Produkte“, lautet die erste Frage: Auf welcher Ebene gezählt?
Hineinzoomen
Von der Entität zum Artikel
Gehen Sie die Ebenen durch. Jede liegt in der vorherigen, und jede hat im Modell ihre eigene Aufgabe.
Entitätstypen
- Kategorie
- Marke
- Lieferant
- Asset
- Dokument
ProduktTrail Runner 2
Marke · Obermaterial · Sprengung · Beschreibung
VarianteBlau, Größe 42
Farbe: Blau · Größe: EU 42
SKUFS-TR2-BLU-42
Bestand · Preis · Lieferzeit
Artikel
- Paar im Karton1 PaarGTIN 2000000000015
- Umkarton6 PaareGTIN 2000000000022
- Blau 41
- Blau 43
- Schwarz 42
Alle Codes sind erfundene Beispiele.
Ebene 1 von 5
Entitätstypen
Ein Entitätstyp ist eine Art von Objekt, zu der das PIM Datensätze führt. Produkte sind ein Typ. Kategorien, Marken, Lieferanten, Assets und Dokumente sind weitere. Jeder Typ hat eigene Attribute und eigene Verknüpfungen zum Rest.
- In diesem Beispiel
- Produkt, Kategorie, Marke, Lieferant, Asset und Dokument
- Wie Systeme den Begriff verwenden
- PIMEntität, Objekttyp oder Datensatztyp
- MDMDatendomäne, etwa Produkt, Kunde oder Lieferant
- DatenbankEine Tabelle, eine Zeile pro Datensatz
Ein Entitätstyp ist eine Art von Objekt, zu der das PIM Datensätze führt. Produkte sind ein Typ. Kategorien, Marken, Lieferanten, Assets und Dokumente sind weitere, jeder mit eigenen Attributen und Verknüpfungen. Ein Produkt ist das Modell, das ein Kunde wiedererkennt und sucht: der Trail Runner 2. Eine Variante ist eine Ausführung, die ein Käufer auswählen kann, definiert durch ihre Variantenattribute, hier die Farbe Blau und die Größe 42. Die SKU (Stock Keeping Unit, Lagerhaltungseinheit) ist der unternehmenseigene Code für genau diese Variante, mit dem sie gezählt, gelagert und verkauft wird. Die Handelseinheit (Trade Item) ist eine Einheit, die auf einer bestimmten Verpackungsebene bepreist, bestellt oder fakturiert wird: ein Paar im Schuhkarton oder ein Umkarton mit sechs Paaren.
Warum die Begriffe Probleme machen
Ein ERP nennt meist jede verkaufbare Einheit einen Artikel und kennt keine Ebene darüber. Ein Onlineshop nennt die Seite ein Produkt und die Optionen darauf Varianten. Ein Lager zählt SKUs pro Lagerplatz. Modeteams sprechen von Styles und Farb-Größen-Kombinationen. Keine dieser Bezeichnungen ist falsch, aber ein Modell, das seine Ebenen nicht klar benennt, endet mit Produktseiten, die aus ERP-Artikeln gebaut sind, oder mit einem eigenen Produkt für jede Größe. Das hat auch kommerzielle Folgen: Manche PIM-Lizenzen werden nach der Zahl der Produkte, SKUs oder Datensätze berechnet, achten Sie also darauf, welche Zählung Sie angeben. PIM für Mode und Bekleidung zeigt, wie sich Style-, Farb- und Größenebenen in einem Katalog auswirken, in dem Varianten dominieren.
GTIN, SKU und Verpackungsebenen
Eine SKU ist intern, deshalb haben ein Lieferant und ein Händler für denselben Schuh jeweils ihre eigene SKU. Eine GTIN (Global Trade Item Number) wird im GS1-System vergeben und ist für jeden Handelspartner gleich: Sie ist die Nummer im Barcode. Jede Verpackungsebene, die gehandelt wird, erhält ihre eigene GTIN, sodass sich das einzelne Paar und der Karton mit sechs Paaren am Scanner unterscheiden lassen. Im Modell gehört die GTIN auf die Ebene der Handelseinheit, nicht an das Produktmodell.
So entwerfen Sie Ihr Produktdatenmodell
Ein Datenmodell lässt sich vor dem ersten Import viel leichter richtig aufsetzen als nach dem ersten großen. Diese Schritte funktionieren für ein erstes PIM ebenso wie für eine Neugestaltung.
Beginnen Sie bei den Kanälen und den Fragen der Käufer
Listen Sie auf, was jeder Kanal braucht: die Vorlagen der Marktplätze, die Filter in Ihrem Onlineshop, die Vergleichstabellen, den Printkatalog und die Datenpools. Die Fragen, die Käufer vor dem Kauf stellen, zeigen Ihnen, welche Attribute es geben muss und welche filterbar sein müssen.
Ordnen Sie jedes Attribut einer Schicht zu und geben Sie ihm genau einen Verantwortlichen
Kennzeichnen Sie jedes Attribut als Stammdaten, Rich Content oder Metadaten, und benennen Sie das System und das Team, die dafür verantwortlich sind. Stammdaten, die das ERP verantwortet, werden im PIM gelesen, nicht dort bearbeitet.
Zeichnen Sie die Produktmodelle und die Variantenachsen
Legen Sie fest, was in Ihrem Katalog ein Produkt ist und welche Attribute Varianten bilden, etwa Farbe und Größe. Bestimmen Sie für jedes Attribut die höchste Ebene, auf der es zutrifft. Beschränken Sie die Variantenebenen auf die Entscheidungen, die ein Käufer tatsächlich trifft.
Bauen Sie die Klassifizierung und die Attributsets auf
Entwerfen Sie den Klassenbaum, der über die Attribute entscheidet, getrennt von der Navigation. Ergänzen Sie globale, Familien- und Klassenattribute mit Typen, Einheiten und Listen, kennzeichnen Sie, was pro Kanal Pflicht ist, und ordnen Sie Ihre Klassen den Standards zu, die Ihre Partner verwenden.
Definieren Sie die Beziehungstypen und testen Sie mit echten Produkten
Benennen Sie jeden Beziehungstyp, seine Richtung und die Attribute, die er trägt, und legen Sie fest, wer ihn pflegt. Laden Sie dann Ihre schwierigsten Produkte, die Bundles, die Ersatzteile und die Artikel mit zehn Varianten, und prüfen Sie, ob das Modell sie ohne Umwege abbildet.
Häufige Fehler bei der Modellierung
Die meisten dieser Fehler beginnen klein und wachsen mit jedem Import. Wer später eine Variantenstruktur oder einen Klassenbaum ändert, muss jedes Produkt darunter migrieren. Deshalb verdient das Modell zu Beginn eines PIM-Projekts echte Zeit für den Entwurf.
Was das für die Wahl eines PIM bedeutet
PIMs unterscheiden sich in ihrem Datenmodell stärker, als ihre Funktionslisten vermuten lassen. Zwei Systeme können beide „Varianten“ und „Beziehungen“ versprechen und sie völlig unterschiedlich umsetzen. Testen Sie das Modell mit Ihren eigenen Produkten, bevor Sie irgendetwas anderes vergleichen.
- Varianten und Vererbung: wie viele Variantenebenen eine Familie haben kann, ob geerbte und lokale Werte klar gekennzeichnet sind und ob Sie Überschreibungen gesammelt finden und zurücksetzen können.
- Hierarchien: ob das PIM eine Hauptklassifizierung und getrennte Navigationsbäume nebeneinander führt und ob ein Produkt in vielen Navigationsbäumen erscheinen kann.
- Klassifizierung und Attributsets: ob Attribute entlang des Klassenbaums vererbt werden, ob sich Anforderungen je Kanal unterscheiden können und ob sich Standards wie GS1 GPC, ETIM oder ECLASS importieren und zuordnen lassen.
- Beziehungen: typisierte Beziehungen mit Richtung, Attribute an der Beziehung und eine Gegenrichtung, die automatisch synchron bleibt.
- Metadaten: Historie, Datenherkunft, Vollständigkeit pro Kanal und Asset-Rechte, über die Sie Berichte erstellen können.
- Änderungen: was passiert, wenn Sie nach dem Go-live einer Familie ein Attribut hinzufügen oder eine Variantenachse ändern.
PIM-Funktionen und Leistungsmerkmale stellt diese Punkte neben die übrigen Funktionen eines PIM, und Was ist PIM erklärt, wie sich das Modell in das Gesamtsystem einfügt. Wenn Sie bereit sind, Anbieter zu vergleichen, zeigt So wählen Sie das richtige PIM aus, wie Sie aus Ihrem Modell eine Demo nach festem Drehbuch machen.
Wie es weitergeht
Frequently asked questions
Was ist ein Produktdatenmodell?
Ein Produktdatenmodell ist der Bauplan, nach dem ein PIM Produkte speichert: welche Arten von Datensätzen es gibt (Produkte, Varianten, Kategorien, Marken, Assets), welche Attribute jede davon hat, wie Datensätze in Hierarchien gruppiert und über Beziehungen verknüpft werden und welche Werte vererbt werden. Es entscheidet, was das PIM abbilden kann und wie viel Arbeit jedes neue Produkt macht.
Was ist der Unterschied zwischen Stammdaten und Rich Content?
Stammdaten identifizieren das Produkt und ändern sich selten: Artikelnummer, GTIN, Marke, Einheiten, Gewicht und Abmessungen. Jedes System braucht dieselben Werte, deshalb werden sie meist im ERP oder in einem MDM angelegt. Rich Content, also die angereicherten Produktdaten, verkauft und erklärt das Produkt: Namen, Beschreibungen, Merkmale, Bilder und Größentabellen. Er ändert sich oft, wird pro Markt übersetzt und im PIM gepflegt.
Was ist der Unterschied zwischen Produkt, Variante und SKU?
Das Produkt ist das Modell, das ein Kunde wiedererkennt, etwa ein bestimmtes Schuhmodell. Eine Variante ist eine Ausführung davon, die ein Käufer auswählen kann, definiert durch Variantenattribute wie Farbe und Größe. Die SKU ist der unternehmenseigene Code für genau eine Variante, mit dem der Bestand gezählt, gelagert und verkauft wird. Eine Variante hat meist eine SKU, aber das Wort bedeutet in jedem System etwas leicht anderes.
Wie funktioniert die Vererbung von Attributen in einem PIM?
Werte werden auf der höchsten Ebene gesetzt, auf der sie zutreffen, und nach unten weitergegeben. Eine Marke oder Beschreibung, die am Produktmodell gesetzt ist, wird an jede Variante vererbt, und ein Wert, der bei einer Farbe gesetzt ist, an jede Größe dieser Farbe. Ändern Sie ihn einmal oben, und jeder Datensatz darunter folgt. Ein Datensatz, der einen anderen Wert braucht, erhält eine Überschreibung. Sie stoppt den geerbten Wert für diesen Datensatz und die Datensätze darunter.
Wann sollte ich eine Produktbeziehung statt einer Hierarchie verwenden?
Verwenden Sie eine Hierarchie, wenn ein Datensatz genau einen natürlichen übergeordneten Datensatz hat und von ihm erben soll, wie bei Kategorien, Produktmodellen und Varianten. Verwenden Sie eine typisierte Beziehung, wenn Datensätze quer zur Hierarchie verknüpft sind: Zubehör, Ersatzteile, kompatible Produkte, Nachfolger, Bundles und Sets. Eine Beziehung verbindet zwei Datensätze, kopiert aber keine Werte zwischen ihnen.
Was ist ein Attributset in einem PIM?
Ein Attributset, oft auch Familie oder Vorlage (Template) genannt, ist die Liste der Attribute, die eine Gruppe von Produkten haben muss oder haben kann. Es baut sich meist entlang der Klassifizierung auf: Attribute, die jedes Produkt hat, weitere aus der Produktfamilie und die spezifischsten aus der Klasse. Es legt außerdem fest, welche Attribute Pflicht sind, oft pro Kanal.
Ist eine GTIN dasselbe wie eine SKU?
Nein. Eine SKU ist ein interner Code des Unternehmens, deshalb haben ein Lieferant und ein Händler für denselben Artikel jeweils eine andere SKU. Eine GTIN ist eine weltweit eindeutige Nummer, die im GS1-System vergeben und im Barcode gedruckt wird, sodass jeder Handelspartner und jeder Scanner dieselbe Nummer sieht. Jede Verpackungsebene, etwa eine Einzeleinheit und ein Karton, erhält ihre eigene GTIN.
Wie viele Variantenebenen sollte ein Produktmodell haben?
So viele, wie es echte Auswahlmöglichkeiten für den Käufer gibt, und meist nicht mehr als zwei. In der Mode sind oft zwei Ebenen üblich, erst Farbe und dann Größe, weil die Bilder zur Farbe gehören und der Bestand zur Größe. Ein Bohrschrauber, der mit oder ohne Akku verkauft wird, braucht eine. Jede zusätzliche Ebene bringt weitere Datensätze, die gepflegt werden müssen. Fügen Sie eine Ebene deshalb nur hinzu, wenn sich die Werte auf dieser Ebene wirklich unterscheiden.
Diagnose
Brauchen Sie überhaupt ein PIM?
Ermitteln Sie Ihren Komplexitätsindex, bevor Sie Software budgetieren oder einen Systemintegrator beauftragen.
Budget
Erste TCO-Schätzung erstellen
Übersetzen Sie die Struktur Ihres Katalogs in weniger als zehn Minuten in eine Kostenspanne über drei Jahre.