Core
Der Produktdatenprozess erklärt: Onboarding, Anreicherung und Publikation
Stephan Spijkers · 2026-10-20 · 12 Min. Lesezeit
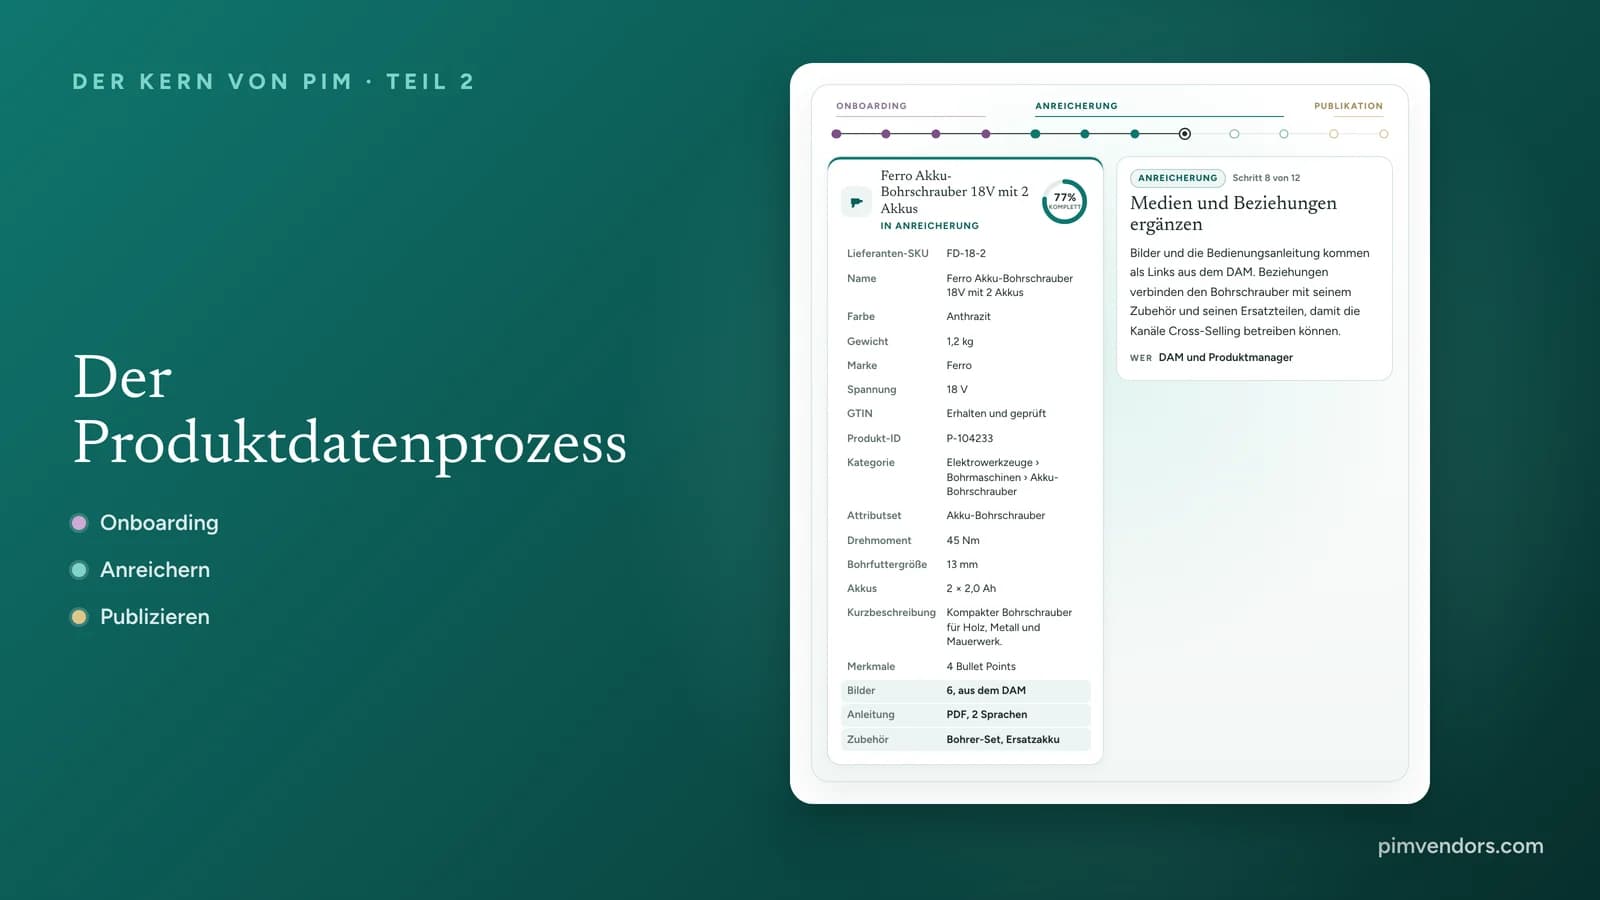
Jedes Produkt in einem Onlineshop, in einem Katalog oder auf einem Marktplatz hat dieselben drei Phasen durchlaufen. Daten kamen von irgendwoher herein, wurden so aufbereitet, dass ein Kunde danach kaufen kann, und wurden an einen Kanal geliefert. In vielen Unternehmen verteilen sich diese Phasen auf Tabellen, Postfächer und Copy-and-paste. Ein PIM bündelt sie zu einem Prozess rund um einen einzigen Produktdatensatz. Dieser Leitfaden geht diesen Prozess durch: was im Onboarding, in der Anreicherung und in der Publikation passiert, wer was tut und wo es meist schiefgeht.
Der Prozess auf einer Linie
Interaktiv
Ein Produkt durch den gesamten Prozess
Begleiten Sie einen neuen Akku-Bohrschrauber vom ersten Import bis zu dem Moment, in dem er live ist. Klicken Sie auf Abspielen oder auf einen beliebigen Schritt.
Unbenannter Import
Importiert
- Lieferanten-SKU
- FD-18-2
- Bezeichnung
- AKKU-BOHRSCHR. 18V 2AH ANTHR
- Farbton
- Anthr.
- Gew. (g)
- 1200
Sammeln
Der Artikel kommt aus zwei Quellen: Das ERP liefert die Artikelnummer und die Basisdaten, der Lieferant schickt eine Tabelle mit allem anderen. Noch ist nichts bereinigt.
WerERP und Lieferantendatei
Die Pipeline oben begleitet einen neuen Akku-Bohrschrauber durch zwölf Schritte. Zwei Dinge fallen auf. Der Datensatz verlässt das PIM nie: Jeder Schritt ergänzt oder verbessert ihn, deshalb liegt nie eine „neueste Version“ in irgendeinem Postfach. Und die Vollständigkeit ist keine Linie, die nur nach oben geht. Sobald der Bohrschrauber klassifiziert ist, weiß das PIM plötzlich, wie ein vollständiger Akku-Bohrschrauber aussieht, und der Wert sinkt, bevor er steigt.
Onboarding: Daten hereinholen
Onboarding umfasst alles, was zwischen einer Quelle und einem nutzbaren Produktdatensatz passiert. Es entscheidet mehr über die Datenqualität als jeder spätere Schritt, denn jeder Fehler, der durchrutscht, wird in jedem Kanal, der ihn erhält, erneut korrigiert.
Woher Produktdaten kommen
Die meisten Produkte kommen aus mehr als einer Quelle gleichzeitig:
- Das ERP legt die Artikelnummer, die Einheiten, die Preise und die Basisdaten des Artikels an. In Teil 1 dieser Serie ist das ERP das führende System für diese Daten, und das PIM liest sie.
- Lieferanten senden Tabellen, BMEcat- oder andere Katalogdateien oder erfassen ihre Daten in einem Lieferantenportal.
- Datenpools wie GS1 GDSN liefern standardisierte Daten von Herstellern, in den Branchen, die solche Pools nutzen.
- Das PLM liefert Konstruktionsdaten für Produkte, die ein Unternehmen selbst entwickelt.
- Das DAM hält die Bilder, Videos und Dokumente.
- Altdateien sind in einem PIM-Projekt oft die erste Quelle: Tabellen aus vielen Jahren, die einmal bereinigt werden müssen.
Die vier Schritte des Onboardings
Onboarding
Von der Lieferantendatei zu sauberen Daten
Gehen Sie Schritt für Schritt durch, was mit einer Zeile aus der Tabelle eines Lieferanten passiert.
- Art.-Nr.FD-18-2Lieferanten-SKUFD-18-2
- EAN(leer)GTINFehltZurück an den Lieferanten
- BezeichnungAKKU-BOHRSCHR. 18V 2AH ANTHRArbeitsnameAkku-Bohrschrauber 18V 2Ah, anthrazit
- FarbtonAnthr.FarbeAnthrazit
- Gew. (g)1200Gewicht1,2 kg
- Maße LxBxH250x80x210Länge · Breite · Höhe250 · 80 · 210 mm
- Volt18Spannung18 V
Phase 1 von 4
Mappen
Jede Spalte wird mit einem Attribut im PIM verbunden. Eine Spalte kann mehrere Attribute befüllen, und manche Spalten werden gar nicht gebraucht.
- Sammeln. Daten werden per Datei, API, Datenpool oder Portal importiert und landen in einem Staging-Bereich statt direkt im Katalog.
- Mappen. Jedes Feld der Quelle wird mit einem Attribut im Datenmodell des PIM verbunden. Das Mapping wird pro Quelle gespeichert, sodass sich die nächste Datei von selbst zuordnet.
- Validieren und bereinigen. Regeln rechnen Einheiten um, schreiben Abkürzungen aus, gleichen Werte mit Wertelisten ab, teilen kombinierte Felder auf und prüfen Formate und Pflichtfelder.
- Abgleichen. Das PIM prüft, ob es das Produkt schon gibt: anhand der GTIN, der Lieferantennummer oder eines unscharfen Abgleichs von Name und technischen Daten. Dann führt es die Datensätze zusammen oder legt einen neuen an.
Staging und Quarantäne
Importierte Daten sollten nicht direkt in den Katalog gehen. Ein Staging-Bereich hält neue Daten zurück, bis sie die Validierung bestehen, und eine Quarantäne nimmt auf, was durchfällt, zusammen mit dem Grund. Der Data Steward bearbeitet dann die Ausnahmen, statt jede Zeile zu prüfen. Darin liegt der Unterschied, ob Sie tausend Produkte an einem Tag übernehmen oder in einem Monat.
Lieferanten in den Prozess einbinden
Die günstigste Korrektur ist die, die der Lieferant vornimmt, bevor er die Datei sendet. Geben Sie Lieferanten eine Vorlage oder ein Portal, das Ihrem Datenmodell folgt, sagen Sie ihnen, welche Attribute für ihre Kategorie Pflicht sind, und schicken Sie Validierungsfehler automatisch zurück. Wo es in Ihrer Branche einen Datenpool oder einen Klassifikationsstandard wie ETIM oder GS1 gibt, nutzen Sie ihn: Ein Lieferant, der bereits in diesem Format liefert, braucht kein individuelles Mapping. Unser Artikel darüber, warum unvollständige Produktdaten mit der Lieferantendatei beginnen, geht ausführlicher darauf ein.
Anreicherung: aus Daten Inhalte machen, die verkaufen
In der Anreicherung wird aus einem Artikel ein Produkt. Hier liegt auch der größte Teil der Arbeit, und hier sind die meisten Menschen beteiligt.
Zuerst klassifizieren
Die Klassifikation gibt dem Produkt seinen Platz: in Ihrem eigenen Kategoriebaum und, wo Sie sie nutzen, in einem Standard wie GS1 GPC, ETIM oder ECLASS. Die Klasse bestimmt das Attributset, also die Liste der Attribute, die zu dieser Art von Produkt gehören, und welche davon Pflicht sind. Deshalb kommt die Klassifikation zuerst. Solange ein Produkt nicht klassifiziert ist, kann niemand sagen, was „vollständig“ für dieses Produkt bedeutet. Teil 3 dieser Serie erklärt, wie Klassen, Attributsets und Vererbung zusammenspielen, und unser Leitfaden zu GS1, ETIM und ECLASS behandelt die Standards.
Spezifizieren, beschreiben und zeigen
Steht das Attributset, wird der Datensatz in drei Ebenen befüllt:
- Spezifikationen: die technischen Attribute der Klasse, aus dem Datenblatt des Lieferanten, aus dem PLM oder vom Produktmanager.
- Beschreibungen: ein Name, der in der Suche funktioniert, Kurz- und Langbeschreibungen, Merkmalslisten und Suchbegriffe. Spezifikationen sagen, was ein Produkt ist, Beschreibungen sagen, warum jemand es kaufen sollte.
- Medien: Bilder, Videos, Anleitungen und Zertifikate, aus dem DAM verlinkt statt kopiert.
Beziehungen und Varianten
Produkte stehen selten für sich allein. Beziehungen verbinden ein Produkt mit seinem Zubehör, seinen Ersatzteilen, Nachfolgern und Alternativen. Darauf beruhen Cross-Selling und die Antworten auf Kompatibilitätsfragen. Varianten fassen Größen und Farben unter einem Produkt zusammen, sodass gemeinsame Inhalte nur einmal geschrieben werden. Beides ist Teil des Datenmodells, und beides behandelt Teil 3.
Lokalisieren
Jeder Markt bekommt seine eigene Sprachversion und manchmal eigene Einheiten, Vorschriften und ein eigenes Sortiment. Die Spezifikationen bleiben meist gleich, Namen, Texte, rechtliche Hinweise und Maßeinheiten richten sich nach dem Markt. Ein PIM hält alle Sprachversionen am selben Datensatz. So erreicht eine Änderung an einer Spezifikation alle Sprachen gleichzeitig, und nur der Text muss übersetzt werden.
Wo KI hilft
KI ist inzwischen in den meisten PIMs Teil der Anreicherung: Sie entwirft Beschreibungen, extrahiert Attribute aus Lieferanten-PDFs, schlägt Klassifikationen vor und übersetzt. Am besten funktioniert sie auf einem sauberen Modell mit klaren Regeln, und ihre Ergebnisse müssen weiterhin auf Fakten, Tonalität und Compliance geprüft werden. Unser Leitfaden dazu, was KI in einem PIM tatsächlich leistet, zeigt, wo sie funktioniert und wo sie scheitert.
Vollständigkeit gilt pro Kanal
Interaktiv
Vollständig für welchen Kanal?
Jeder Kanal braucht andere Attribute. Deshalb kann ein Produkt für Print bereit sein und für einen Marktplatz noch lange nicht. Befüllen oder leeren Sie Attribute und beobachten Sie jeden Kanal.
- OMPD
- OMPD
- OMPD
- OMPD
- OMPD
- OMPD
- OMPD
- OMPD
- OMPD
- OMPD
- OMPD
Ein einziger Vollständigkeitswert führt in die Irre. Der Onlineshop braucht Langbeschreibungen und zusätzliche Bilder, der Marktplatz Bullet Points und eine GTIN, der Printkatalog kurze Texte, der Datenpool Gewichte, Abmessungen und Sicherheitsdokumente. Ein PIM misst die Vollständigkeit pro Kanal und oft pro Sprache und blockiert die Veröffentlichung in einem Kanal, bis dessen Anforderungen erfüllt sind. Probieren Sie es oben aus: Dasselbe Produkt ist für Print bereit und für den Marktplatz noch weit davon entfernt.
Prüfung und Freigabe
Bevor etwas veröffentlicht wird, prüfen Qualitätsregeln den Datensatz, und eine Person gibt ihn frei. In kleinen Teams ist das ein einziger Prüfschritt, in größeren leitet ein Workflow das Produkt über Spezialisten und Freigebende. Unser Leitfaden zu Produktdatenqualität und Data Governance behandelt die Regeln und Rollen dahinter.
Publikation: ein Datensatz, jeder Kanal
In der Publikation trifft der freigegebene Datensatz auf die Kanäle. Die Aufgabe des PIM ist hier nicht, überall dieselben Daten hinzuschicken, sondern jedem Kanal genau das, was er braucht, in seinem Format und nach seinen Regeln, und zwar aus demselben Datensatz.
Publikation
Ein Datensatz, fünf Ausgaben
Derselbe freigegebene Datensatz wird in jedem Kanal zu etwas anderem. Wählen Sie einen Kanal und zeigen Sie auf ein Feld, um zu sehen, wo es landet.
Freigegebener Datensatz
Zeigen Sie auf ein Feld, um es zu verfolgen
Ferro Akku-Bohrschrauber 18V, 45 Nm, 13 mm Bohrfutter, 2 × 2,0 Ah Akkus
Kategorie: Werkzeuge › Elektrowerkzeuge › Bohrmaschinen
• KRAFTVOLL: 45 Nm Drehmoment für Holz und Metall
• VIELSEITIG: 13 mm Schnellspannbohrfutter
• SOFORT EINSATZBEREIT: zwei 2,0-Ah-Akkus inklusive
• LEICHT: nur 1,2 kg
Produkt-ID: GTIN 2000000000039
Was sich für diesen Kanal geändert hat
- Titel aus Marke, Typ und den wichtigsten technischen Daten, in der Reihenfolge des Marktplatzes
- Auf den eigenen Kategoriebaum des Marktplatzes gemappt
- Bullet Points im Stil des Marktplatzes, ohne GTIN kein Listing
Kanalanforderungen und Mapping
Jeder Kanal hat eigene Attributnamen, einen eigenen Kategoriebaum, eigene Wertelisten und eigene Grenzen. Marktplätze bilden Titel nach einem festen Muster und verlangen Identifikatoren. Datenpools nutzen eine eigene Attributstruktur und Codelisten für Einheiten. Print braucht kurze Texte mit fester Länge. Das PIM hält pro Kanal ein Mapping, das den Datensatz in die Version des Kanals übersetzt, sodass niemand ein Produkt für jedes Ziel von Hand umschreibt. Speziell zu Marktplätzen lesen Sie unseren Leitfaden zu PIM und Marktplätzen.
Wie die Daten in die Kanäle gelangen
- APIs liefern Produktdaten an Ihren eigenen Onlineshop, Ihre Apps und Frontends, oft in Echtzeit.
- Feeds senden Dateien nach Zeitplan an Marktplätze, Preisvergleichsportale und Händler.
- Datenpools verteilen standardisierte Daten an Händler in Branchen wie Lebensmittel, Gesundheit und Baumarkt.
- Print und Dokumente entstehen aus Vorlagen für Kataloge, Datenblätter und Preislisten.
- Maschinenlesbare Endpunkte lassen KI-Einkaufsagenten und Antwortmaschinen strukturierte Produktdaten lesen. Unser Leitfaden zu KI-fähigen Produktdaten erklärt, was diese brauchen.
Die meisten Kanäle erhalten Änderungen als Delta statt jedes Mal den vollständigen Katalog. Das hält Feeds schnell und macht deutlich, was sich geändert hat.
Den Kreislauf schließen
Kanäle antworten. Ein Marktplatz lehnt ein Listing ab, ein Händler meldet ein falsches Gewicht, ein Datenpool gibt einen Validierungsfehler zurück, ein Kunde stellt dreimal dieselbe Frage. Jeder dieser Fälle ist Anreicherungsarbeit. In einem guten Prozess erreicht das Feedback das PIM, landet auf der Aufgabenliste der richtigen Person, und der korrigierte Datensatz wird erneut veröffentlicht. Deshalb ist die Publikation der Start der nächsten Runde, nicht das Ende der Strecke.
Workflow und Governance im gesamten Prozess
Ein Produkt durchläuft verschiedene Status: Entwurf, in Anreicherung, in Prüfung, freigegeben, veröffentlicht und am Ende seines Lebenszyklus ausgelistet. Jede Änderung nach der Veröffentlichung, von einer Aktualisierung durch den Lieferanten bis zum Feedback eines Kanals, schickt es für diese Änderung zurück in die Anreicherung und erneut durch die Prüfung. Die Status machen den Prozess sichtbar: Alle sehen, was wartet, auf wen und wie lange.
Governance legt fest, wer in welchem Status was tun darf. Das Wesentliche:
- Ein Verantwortlicher pro Attribut. Der Produktmanager verantwortet die Spezifikationen, das Marketing die Texte, das DAM-Team die Medien, der Channel Manager die Kanalversionen.
- Regeln vor Menschen. Validierungsregeln fangen ab, was sich automatisch abfangen lässt, damit Prüfer ihre Zeit für Ermessensfragen nutzen und nicht für fehlende Einheiten.
- Freigabe vor Veröffentlichung. Nichts erreicht einen Kanal, ohne dessen Anforderungen zu erfüllen und, wo es darauf ankommt, von einer Person freigegeben zu sein.
- Ein Audit-Trail. Jede Änderung hält fest, wer sie vorgenommen hat, wann und aus welcher Quelle.
Den Prozess messen
Ein Prozess, den Sie nicht messen, kann nicht schneller werden. Die wichtigsten Kennzahlen:
- Time-to-Market: vom ersten Import bis live in jedem Kanal.
- Vollständigkeit pro Kanal: wie viele Produkte die Anforderungen jedes Kanals erfüllen.
- First-Time-Right-Quote: wie viele Produkte Validierung und Prüfung bestehen, ohne zurückzugehen.
- Ablehnungen durch Kanäle: wie viele Listings oder Datenpool-Meldungen mit Fehlern zurückkommen, und warum.
- Qualität der Lieferantendaten: wie viele Probleme die Dateien der einzelnen Lieferanten verursachen. Daran sehen Sie, wo sich Investitionen in Vorlagen oder Onboarding lohnen.
Wo der Prozess bricht
Den Prozess in einem PIM aufsetzen
Erfassen Sie Quellen und Kanäle
Listen Sie jede Quelle von Produktdaten und jeden Kanal auf, an den die Daten gehen, mit den Formaten und den Verantwortlichen auf beiden Seiten. Das ist der Umriss Ihres Prozesses.
Legen Sie das Datenmodell und die Anforderungen pro Kanal fest
Einigen Sie sich auf die Klassifikation, die Attributsets und darauf, welche Attribute jeder Kanal verlangt. Die Vollständigkeit lässt sich nur an diesen Anforderungen messen.
Bauen Sie das Onboarding pro Quelle auf
Legen Sie für jede Quelle ein Mapping und Validierungsregeln an, einen Staging-Bereich für neue Daten und einen Rückweg zum Lieferanten für alles, was durchfällt.
Richten Sie Anreicherungs-Workflows und Verantwortliche ein
Geben Sie jeder Attributgruppe einen Verantwortlichen, leiten Sie Produkte über die richtigen Personen und bauen Sie Prüfung und Freigabe vor der Veröffentlichung ein.
Binden Sie die Kanäle und das Feedback an
Bauen Sie die Kanal-Mappings, wählen Sie für jeden Kanal API, Feed, Datenpool oder Print und sorgen Sie dafür, dass Ablehnungen und Fragen als Aufgaben zurück ins PIM kommen.
Worauf Sie bei einem PIM achten sollten
Der Prozess stellt konkrete Anforderungen an das System. Wenn Sie PIMs vergleichen, lassen Sie sich Folgendes mit Ihren eigenen Daten zeigen:
- Import und Mapping: gespeicherte Mappings pro Lieferant, Transformationsregeln, Staging und Quarantäne sowie bei Bedarf ein Lieferantenportal oder eine Datenpool-Anbindung.
- Datenmodell und Klassifikation: Attributsets pro Klasse, Vererbung und Varianten sowie Unterstützung für die Standards Ihrer Branche.
- Vollständigkeit und Validierung: Regeln pro Kanal und pro Sprache, wobei die Veröffentlichung blockiert bleibt, bis die Anforderungen erfüllt sind.
- Workflow: Status, Verantwortliche, Aufgaben und Freigaben, die zu Ihrem Team passen, nicht zur Demo des Anbieters.
- Syndizierung: fertige Konnektoren für Ihre Kanäle, Kanal-Mappings, die Sie selbst pflegen können, und ein Weg, Feedback aus den Kanälen zu verarbeiten.
Unsere Übersicht über Funktionen und Möglichkeiten von PIM enthält die vollständige Liste, und der Leitfaden zur PIM-Implementierung zeigt, wie Sie den Prozess in einem Projekt aufsetzen.
Wie es weitergeht
Frequently asked questions
Was ist Produktdaten-Onboarding?
Onboarding ist der Weg, auf dem Produktdaten ins PIM gelangen: Sie werden aus dem ERP, von Lieferanten, aus Datenpools und anderen Quellen gesammelt, auf das Datenmodell des PIM gemappt, bereinigt und validiert und mit bereits vorhandenen Produkten abgeglichen. Gutes Onboarding hält schlechte Daten an der Tür auf, statt sie später in jedem Kanal zu korrigieren.
Was ist Produktdatenanreicherung?
Die Anreicherung macht aus einfachen Artikeldaten Inhalte, die verkaufen und die Vorschriften erfüllen: Klassifikation, technische Attribute, Namen und Beschreibungen, Bilder und Dokumente, Beziehungen zu anderen Produkten und Übersetzungen. Daran sind meist mehrere Teams beteiligt, zunehmend auch KI, und vor der Veröffentlichung wird alles geprüft und freigegeben.
Was ist Produktdaten-Syndizierung?
Syndizierung bedeutet, Produktdaten an externe Kanäle auszuspielen, in dem Format, das jeder Kanal verlangt: Marktplätze, Händler, Datenpools wie GS1 GDSN, Print und KI-Agenten. Das PIM hält einen Datensatz, erzeugt daraus für jedes Ziel eine kanalspezifische Version und verarbeitet anschließend die Rückmeldungen, die die Kanäle zurücksenden.
Was bedeutet Vollständigkeit in einem PIM?
Die Vollständigkeit misst, wie viele der Pflichtattribute eines Produkts befüllt sind. Sie wird pro Kanal und oft pro Sprache gemessen, weil jeder Kanal andere Attribute verlangt. Ein Produkt kann gleichzeitig für Print vollständig und für einen Marktplatz unvollständig sein.
Wer ist für die Anreicherung von Produktdaten verantwortlich?
Die Verantwortung ist geteilt. Produktmanager verantworten die technischen Attribute, Marketing- oder Content-Teams die Texte, das DAM-Team die Medien, Übersetzer die Sprachen und Channel Manager die Kanalversionen. Damit das funktioniert, braucht es Data Governance: Jedes Attribut hat genau einen Verantwortlichen, und ein Workflow leitet Produkte an die richtige Person und an eine freigebende Person weiter.
Kann KI Produktdaten automatisch anreichern?
KI kann Beschreibungen entwerfen, Attribute aus Lieferantendokumenten extrahieren, Klassifikationen vorschlagen und übersetzen. Am besten funktioniert sie auf einem sauberen Datenmodell mit klaren Regeln, und ihre Ergebnisse müssen vor der Veröffentlichung weiterhin auf Fakten, Tonalität und Compliance geprüft werden.
Wie beschleunigen Sie das Onboarding von Lieferanten?
Geben Sie Lieferanten eine Vorlage oder ein Portal, das Ihrem Datenmodell folgt, speichern Sie das Mapping für jeden Lieferanten, damit sich die nächste Datei von selbst zuordnet, validieren Sie beim Import, schicken Sie Probleme automatisch an den Lieferanten zurück und nutzen Sie Datenpools, wo es in Ihrer Branche einen gibt.
Was ist der Unterschied zwischen Publikation und Syndizierung?
Publikation bedeutet meist, freigegebene Produktdaten für die eigenen Kanäle bereitzustellen, etwa für den Onlineshop und Print. Syndizierung bedeutet, sie an Kanäle zu senden, die Sie nicht selbst steuern, etwa Marktplätze, Händler und Datenpools, in deren Formaten und nach deren Regeln. In der Praxis erledigt das PIM beides aus demselben Datensatz.
Diagnose
Brauchen Sie überhaupt ein PIM?
Ermitteln Sie Ihren Komplexitätsindex, bevor Sie Software budgetieren oder einen Systemintegrator beauftragen.
Budget
Erste TCO-Schätzung erstellen
Übersetzen Sie die Struktur Ihres Katalogs in weniger als zehn Minuten in eine Kostenspanne über drei Jahre.